Назад
Каждый инженер, который хоть раз настраивал выгрузку данных из 1С в корпоративное хранилище (DWH) или озеро данных (Data Lake), сталкивался с одной и той же проблемой. С одной стороны, полная выгрузка всего массива данных создает высокую нагрузку как на саму 1С, так и на инфраструктуру приемника. С другой - классический подход с обновлением записей по ключу (UPSERT или MERGE) не сохраняет историю изменений. Мы получаем актуальное состояние на текущий момент, но не можем узнать, каким был статус заказа неделю назад, у какого менеджера числился клиент до перераспределения или как менялись цены.
В архитектуре Append-only в приемник добавляются только новые записи: источник отдает срез состояния, а старые строки не перезаписываются и не удаляются. Так сохраняется последовательность изменений - аудит-след, по которому можно понять, что и когда менялось в данных.
В этой статье разберем, как реализовать такую архитектуру и справиться с неочевидными подводными камнями вроде удаленных записей и пустых сегментов.
Режим добавления - это подход, при котором новые или измененные порции (сегменты или партиции) дописываются в конец существующей таблицы-приемника. Никакие старые строки не удаляются и не изменяются.
Плюсы такого подхода:
Главный компромисс в том, что усложняется обработка данных при чтении. Поскольку в таблице может храниться десяток версий одного объекта, для получения актуального среза аналитикам приходится использовать оконные функции.
Главная особенность выгрузки в том, что Экстрактор 1С (например, работающий на подписках на события) фиксирует сам факт изменения в системе. Если документ просто перепровели задним числом, но его содержательные реквизиты не изменились, подписка все равно может сработать, и Экстрактор 1С сформирует новую запись.
Так как наш приемник настроен на режим «Добавление» (Append-only), он не удаляет старую запись, а просто дописывает новую пачку данных. В результате в таблице формируется полная хронология: каждая выгрузка сохраняется как отдельная версия строки с меткой времени (extraction_timestamp) или идентификатором пачки (batch_id).
В архитектуре Append-only мы сталкиваемся с противоречием: физически удалять строки в приемнике нельзя. Но что происходит, когда объект в 1С удаляют или помечают на удаление?
Благодаря тому, что Экстрактор 1С работает на подписках на события или планах обмена, он «знает» об удалении: пометка на удаление или удаление объекта в 1С фиксируются как обычное событие изменения. Экстрактор 1С формирует и выгружает актуальное состояние объекта, где флаг удаления установлен в истину (is_deleted = true).
Приемник в режиме Append-only не удаляет старые исторические строки, а просто дописывает эту новую запись-свидетель (tombstone) в конец таблицы. Когда аналитическая витрина собирает актуальный срез через оконную функцию, она видит последнюю версию строки с флагом is_deleted = true и корректно исключает объект из актуальных данных, сохраняя при этом всю его историю до момента удаления.
Представим ситуацию: наступила ночь, отработал регламент выгрузки из 1С. За прошедший день в проверяемом разделе не было никаких изменений, либо фильтр Экстрактора 1С не вернул ни одной строки. Что происходит дальше?
Здесь кроется опасная ловушка для инженера.
Если пайплайн ожидает получить файл или порцию данных по расписанию, полная тишина (отсутствие файлов или пустой ответ) может означать две совершенно разные вещи:
Чтобы система мониторинга и сам загрузчик не путали штатное отсутствие изменений со сбоем, применяется выгрузка служебного файла-метки (или пустой пачки с метаданными). Такой файл содержит заголовок и подтверждает: выгрузка штатно отработала, за этот период изменений нет. Приемник обрабатывает эту метку корректно, не выдавая ошибку из-за отсутствия данных и не ломая логику партиционирования.
Типовой процесс доставки данных выглядит следующим образом:
Связка точечных изменений из 1С (по ссылкам через подписки или планы обмена), выгрузки актуальных данных и режима добавления (Append-only) на стороне приемника позволяет сохранять историю изменений в корпоративном хранилище и использовать ее для аудита.
В результате:
Единственная плата за сохранение истории - постоянный рост объема данных в таблицах. Но в современных аналитических хранилищах эта проблема легко решается грамотным партиционированием, колоночной компрессией и настройкой политик хранения (TTL) для устаревших версий.
Шаг 1. Создание проекта выгрузки в интерфейсе Экстрактора 1С
Сначала создадим проект выгрузки на стороне источника.
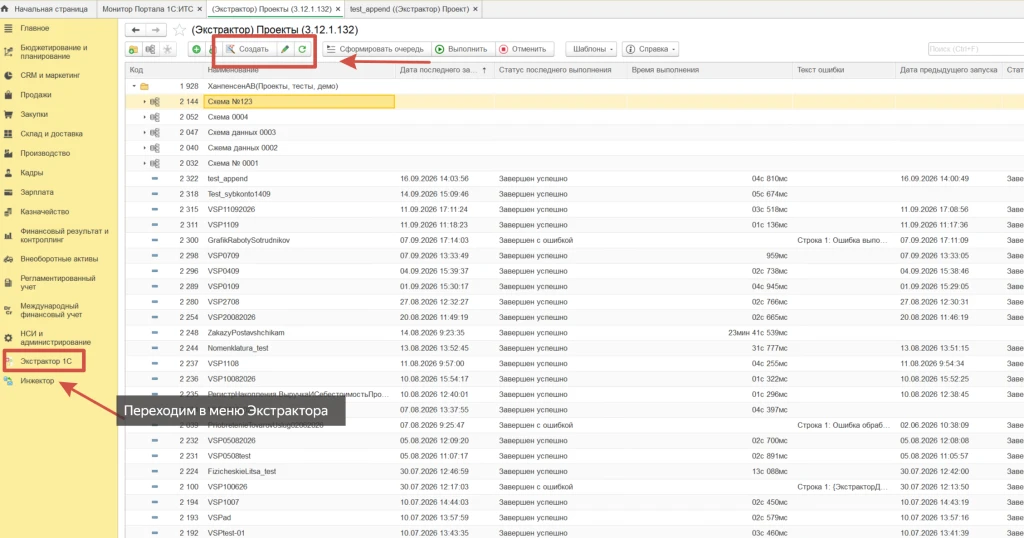
Переходим в меню «Экстрактор 1С», где можно управлять выгрузками, отслеживать их статусы и смотреть историю запусков.
Для настройки новой схемы передачи данных нажимаем кнопку «Создать» на верхней панели управления. Откроется мастер построения (конструктор), в котором мы задаем параметры будущей выгрузки: от выбора объектов метаданных до конфигурации целевой базы и режима записи.
Шаг 2. Выбор типа источника данных
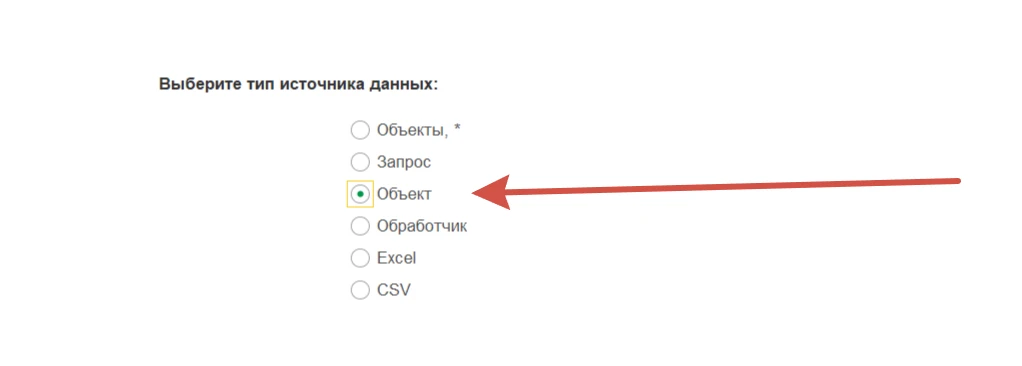
Далее мастер настройки предлагает определить, откуда именно будут загружаться данные. Можно выбрать запрос, обработчик, файлы Excel или CSV - для нашей задачи выбираем пункт «Объект».
Главное преимущество этого способа - доступность: настроить выгрузку может любой пользователь 1С или аналитик без необходимости знать язык программирования или писать сложные SQL-запросы. Система позволяет напрямую сопоставить метаданные без написания программного кода.
Шаг 3. Выбор целевого объекта конфигурации
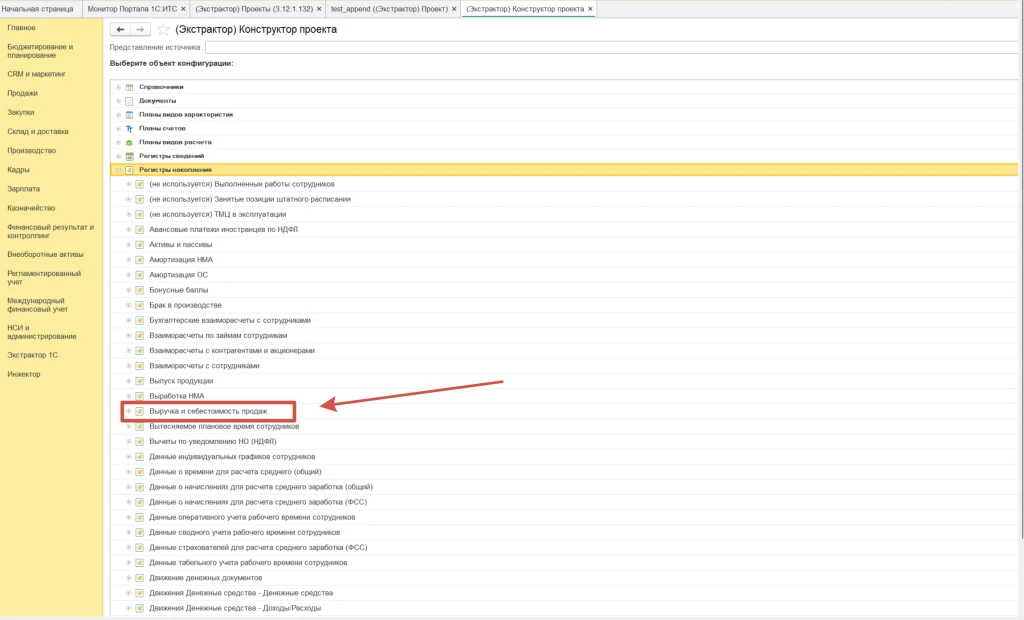
Выбираем объект конфигурации. Мастер открывает дерево метаданных конфигурации 1С: справочники, документы, планы видов характеристик, регистры сведений и накопления. Разворачиваем нужную ветку и выбираем объект, данные которого будем выгружать в хранилище - например, регистр накопления «Выручка и себестоимость продаж», как показано на скриншоте.
Шаг 5. Выбор полей объекта для выгрузки
Далее определяем структуру будущей таблицы в базе данных, выбирая из дерева метаданных только те поля, которые действительно необходимы для аналитики.
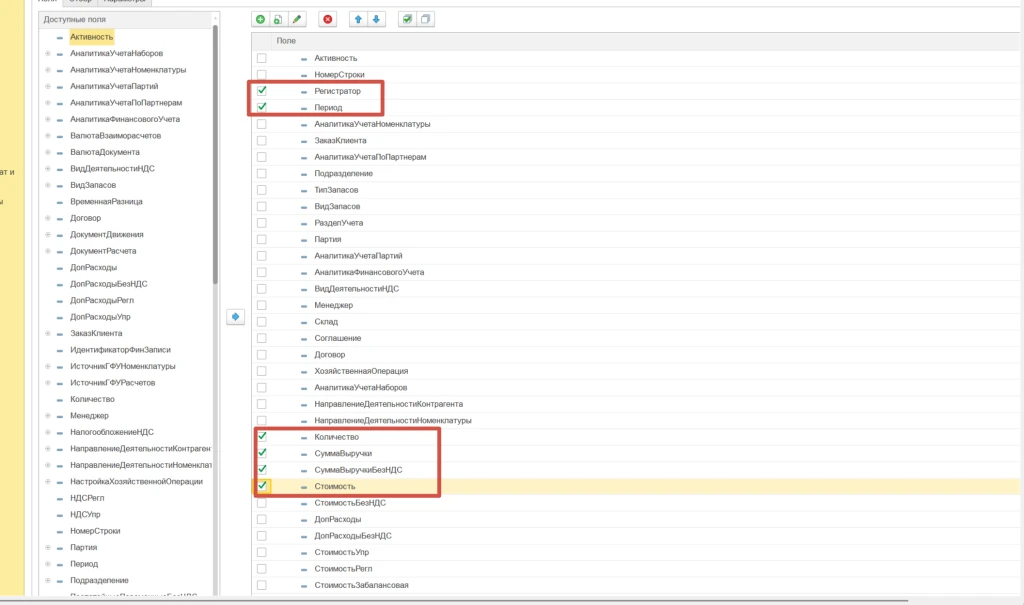
Как показано на скриншоте, мы можем точечно отметить галочками нужные реквизиты и показатели (например, «Регистратор», «Период», а также ключевые метрики вроде «Количество», «СуммаВыручки» и «Стоимость»). Так мы не передаем лишние поля, уменьшаем объем данных и снижаем нагрузку на сеть.
Шаг 7. Настройка режима обновления (Append-only)
Это заключительный шаг, на котором мы задаем механику поведения пайплайна в целевой базе данных.
Как показано на скриншоте в настройках строки проекта, в поле «Способ обновления» переключаем значение с «Обновление сегмента» на «Добавление». В режиме Append-only Экстрактор 1С не перезаписывает и не удаляет данные в таблице приемника, а выполняет исключительно дозапись новых строк (инсерты), формируя чистый и непрерывный аудит-след изменений.
После этого нажимаем кнопку «Применить и закрыть» - проект полностью готов к первому запуску и инкрементальной выгрузке.
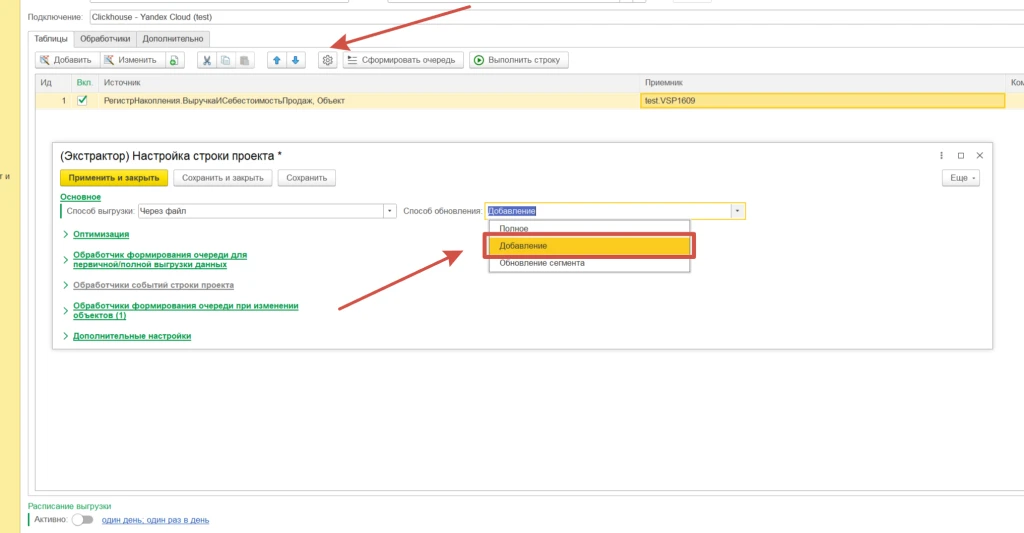
Настройка завершена. При каждом запуске Экстрактора 1С новые данные будут аккуратно и безопасно добавляться в целевую базу данных (Append-only), а не перезаписывать или затирать то, что уже было выгружено ранее. Режим Append-only сохраняет исторический след, разгружает сеть и позволяет строить надежную аналитику на актуальных данных без лишних рисков.
В архитектуре Append-only в приемник добавляются только новые записи: источник отдает срез состояния, а старые строки не перезаписываются и не удаляются. Так сохраняется последовательность изменений - аудит-след, по которому можно понять, что и когда менялось в данных.
В этой статье разберем, как реализовать такую архитектуру и справиться с неочевидными подводными камнями вроде удаленных записей и пустых сегментов.
Почему Append-only, а не Upsert
Режим добавления - это подход, при котором новые или измененные порции (сегменты или партиции) дописываются в конец существующей таблицы-приемника. Никакие старые строки не удаляются и не изменяются.
Плюсы такого подхода:
- Скорость записи: операции INSERT работают значительно быстрее, чем тяжелые транзакционные пересчеты и блокировки при UPDATE или DELETE, особенно на больших объемах аналитических данных.
- Аудит-след из коробки: мы получаем полную историю изменений объекта во времени.
- Безопасность пайплайна: ошибка в логике или сбой во время загрузки не приведут к безвозвратной порче исторических данных, так как старые пачки не затрагиваются.
Главный компромисс в том, что усложняется обработка данных при чтении. Поскольку в таблице может храниться десяток версий одного объекта, для получения актуального среза аналитикам приходится использовать оконные функции.
Как накапливать состояние объекта
Главная особенность выгрузки в том, что Экстрактор 1С (например, работающий на подписках на события) фиксирует сам факт изменения в системе. Если документ просто перепровели задним числом, но его содержательные реквизиты не изменились, подписка все равно может сработать, и Экстрактор 1С сформирует новую запись.
Так как наш приемник настроен на режим «Добавление» (Append-only), он не удаляет старую запись, а просто дописывает новую пачку данных. В результате в таблице формируется полная хронология: каждая выгрузка сохраняется как отдельная версия строки с меткой времени (extraction_timestamp) или идентификатором пачки (batch_id).
Нюанс № 1: Удаленные записи
В архитектуре Append-only мы сталкиваемся с противоречием: физически удалять строки в приемнике нельзя. Но что происходит, когда объект в 1С удаляют или помечают на удаление?
Благодаря тому, что Экстрактор 1С работает на подписках на события или планах обмена, он «знает» об удалении: пометка на удаление или удаление объекта в 1С фиксируются как обычное событие изменения. Экстрактор 1С формирует и выгружает актуальное состояние объекта, где флаг удаления установлен в истину (is_deleted = true).
Приемник в режиме Append-only не удаляет старые исторические строки, а просто дописывает эту новую запись-свидетель (tombstone) в конец таблицы. Когда аналитическая витрина собирает актуальный срез через оконную функцию, она видит последнюю версию строки с флагом is_deleted = true и корректно исключает объект из актуальных данных, сохраняя при этом всю его историю до момента удаления.
Нюанс № 2: Пустой сегмент при выгрузке
Представим ситуацию: наступила ночь, отработал регламент выгрузки из 1С. За прошедший день в проверяемом разделе не было никаких изменений, либо фильтр Экстрактора 1С не вернул ни одной строки. Что происходит дальше?
Здесь кроется опасная ловушка для инженера.
Если пайплайн ожидает получить файл или порцию данных по расписанию, полная тишина (отсутствие файлов или пустой ответ) может означать две совершенно разные вещи:
- Изменений в учетной системе действительно не было.
- Пайплайн сломался, выгрузка из 1С завершилась с ошибкой, и данные просто не дошли.
Чтобы система мониторинга и сам загрузчик не путали штатное отсутствие изменений со сбоем, применяется выгрузка служебного файла-метки (или пустой пачки с метаданными). Такой файл содержит заголовок и подтверждает: выгрузка штатно отработала, за этот период изменений нет. Приемник обрабатывает эту метку корректно, не выдавая ошибку из-за отсутствия данных и не ломая логику партиционирования.
Архитектурная схема пайплайна
Типовой процесс доставки данных выглядит следующим образом:
- Источник (1С): сбор измененных объектов по дате модификации или моменту времени и формирование среза состояний.
- Транспорт и стейджинг: запись измененных объектов Экстрактором 1С в промежуточную таблицу слоя (например, в PostgreSQL или ClickHouse), откуда данные поступают в основное хранилище.
- Приемник (DWH): загрузка данных строго методом добавления (INSERT INTO). Никаких операций обновления или удаления старых строк.
- Витрина данных: представление или материализованная таблица, которая с помощью дедупликации и оконных функций формирует актуальные срезы из истории для бизнес-пользователей.
Итог: история вместо перезаписи
Связка точечных изменений из 1С (по ссылкам через подписки или планы обмена), выгрузки актуальных данных и режима добавления (Append-only) на стороне приемника позволяет сохранять историю изменений в корпоративном хранилище и использовать ее для аудита.
В результате:
- Снимаем нагрузку с 1С и сети за счет передачи только реально изменившихся данных, а не гигантских таблиц целиком.
- Сохраняем аудит-след, фиксируя всю эволюцию объектов во времени без риска случайно затереть историю.
- Упрощаем архитектуру приемника, избавлясь от тяжелых и медленных операций UPDATE/DELETE.
Единственная плата за сохранение истории - постоянный рост объема данных в таблицах. Но в современных аналитических хранилищах эта проблема легко решается грамотным партиционированием, колоночной компрессией и настройкой политик хранения (TTL) для устаревших версий.
Практическая реализация: пошаговая настройка выгрузки методом добавления (Append-only) в 1С
Шаг 1. Создание проекта выгрузки в интерфейсе Экстрактора 1С
Сначала создадим проект выгрузки на стороне источника.
Переходим в меню «Экстрактор 1С», где можно управлять выгрузками, отслеживать их статусы и смотреть историю запусков.
Для настройки новой схемы передачи данных нажимаем кнопку «Создать» на верхней панели управления. Откроется мастер построения (конструктор), в котором мы задаем параметры будущей выгрузки: от выбора объектов метаданных до конфигурации целевой базы и режима записи.
Шаг 2. Выбор типа источника данных
Далее мастер настройки предлагает определить, откуда именно будут загружаться данные. Можно выбрать запрос, обработчик, файлы Excel или CSV - для нашей задачи выбираем пункт «Объект».
Главное преимущество этого способа - доступность: настроить выгрузку может любой пользователь 1С или аналитик без необходимости знать язык программирования или писать сложные SQL-запросы. Система позволяет напрямую сопоставить метаданные без написания программного кода.
Шаг 3. Выбор целевого объекта конфигурации
Выбираем объект конфигурации. Мастер открывает дерево метаданных конфигурации 1С: справочники, документы, планы видов характеристик, регистры сведений и накопления. Разворачиваем нужную ветку и выбираем объект, данные которого будем выгружать в хранилище - например, регистр накопления «Выручка и себестоимость продаж», как показано на скриншоте.
Шаг 4. Настройка сегментирования и гранулярности данных
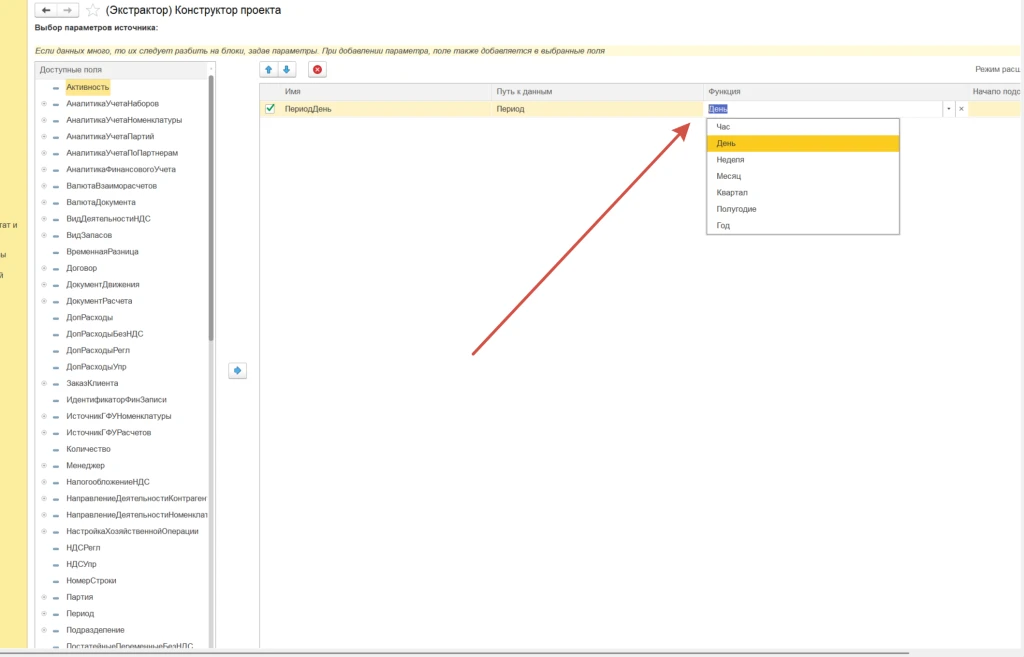
На этом этапе настраиваем детализацию данных по времени: час, день, неделю, месяц и т.д.
Исторические данные делим на отдельные сегменты по выбранному периоду. При первой (полной) выгрузке система забирает данные порциями по этим сегментам. В дальнейшем это позволяет эффективно и последовательно догружать актуальные изменения прямо в целевую базу данных, не перегружая канал и систему.
На этом этапе настраиваем детализацию данных по времени: час, день, неделю, месяц и т.д.
Исторические данные делим на отдельные сегменты по выбранному периоду. При первой (полной) выгрузке система забирает данные порциями по этим сегментам. В дальнейшем это позволяет эффективно и последовательно догружать актуальные изменения прямо в целевую базу данных, не перегружая канал и систему.
Шаг 5. Выбор полей объекта для выгрузки
Далее определяем структуру будущей таблицы в базе данных, выбирая из дерева метаданных только те поля, которые действительно необходимы для аналитики.
Как показано на скриншоте, мы можем точечно отметить галочками нужные реквизиты и показатели (например, «Регистратор», «Период», а также ключевые метрики вроде «Количество», «СуммаВыручки» и «Стоимость»). Так мы не передаем лишние поля, уменьшаем объем данных и снижаем нагрузку на сеть.
Шаг 6. Сопоставление полей (маппинг)
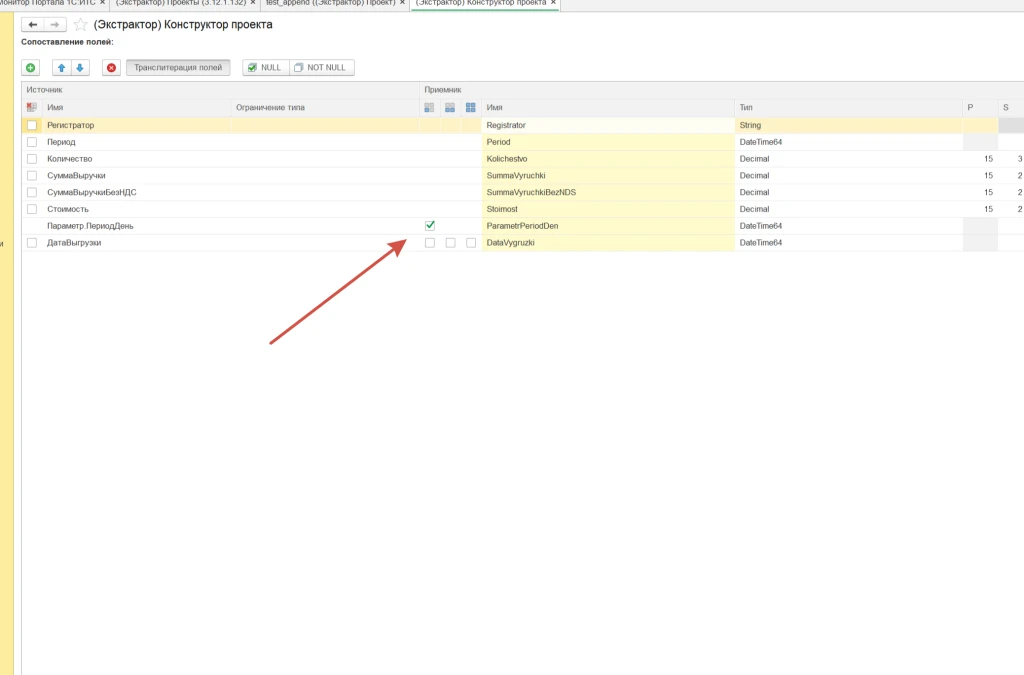
На этом этапе мы настраиваем маппинг данных. В таблице сопоставления слева отображаются выбранные поля-источники из 1С, а справа - соответствующие им поля-приемники, которые будут передаваться в целевую базу данных.
Обратите внимание: Экстрактор 1С автоматически подставил в маппинг выбранный нами ранее сегмент (в данном случае - параметр периода по дням). Системную галочку здесь снимать не требуется, так как именно этот параметр отвечает за разделение данных и инкрементальную доставку по сегментам.
На этом этапе мы настраиваем маппинг данных. В таблице сопоставления слева отображаются выбранные поля-источники из 1С, а справа - соответствующие им поля-приемники, которые будут передаваться в целевую базу данных.
Обратите внимание: Экстрактор 1С автоматически подставил в маппинг выбранный нами ранее сегмент (в данном случае - параметр периода по дням). Системную галочку здесь снимать не требуется, так как именно этот параметр отвечает за разделение данных и инкрементальную доставку по сегментам.
Шаг 7. Настройка режима обновления (Append-only)
Это заключительный шаг, на котором мы задаем механику поведения пайплайна в целевой базе данных.
Как показано на скриншоте в настройках строки проекта, в поле «Способ обновления» переключаем значение с «Обновление сегмента» на «Добавление». В режиме Append-only Экстрактор 1С не перезаписывает и не удаляет данные в таблице приемника, а выполняет исключительно дозапись новых строк (инсерты), формируя чистый и непрерывный аудит-след изменений.
После этого нажимаем кнопку «Применить и закрыть» - проект полностью готов к первому запуску и инкрементальной выгрузке.
Настройка завершена. При каждом запуске Экстрактора 1С новые данные будут аккуратно и безопасно добавляться в целевую базу данных (Append-only), а не перезаписывать или затирать то, что уже было выгружено ранее. Режим Append-only сохраняет исторический след, разгружает сеть и позволяет строить надежную аналитику на актуальных данных без лишних рисков.