 Назад
Попросить AI-агента посчитать продажи за месяц уже несложно. Сложности начинаются, когда вслед за первым вопросом появляются десятки других: сравнить периоды, объяснить падение маржи, проверить остатки и сопоставить выручку с себестоимостью. Если агент каждый раз обращается напрямую к рабочей базе 1С, аналитика начинает конкурировать за ресурсы с оперативным учётом.
На вебинаре «LLM + OData + 1С: выдержит ли рабочая база AI-аналитику?», состоявшемся 1 октября 2026 года, технический директор «Денвик Аналитики» Степан Пыстин разобрал путь от прямых запросов к 1С через OData до отдельного контура данных с инкрементальной выгрузкой, ClickHouse и управлением через MCP. Разбираем техническую механику этого подхода и результаты показанной демонстрации.
Представим обычный сценарий: руководитель пишет агенту «Посчитай сумму продаж за октябрь». Агент находит подходящие объекты 1С, запрашивает записи реализации, получает данные, вычисляет итог и возвращает таблицу или график. Пользователю не нужно разбираться в структуре базы и писать запрос самостоятельно.
Для такого взаимодействия в 1С можно опубликовать стандартный интерфейс OData. Информационную базу размещают на веб-сервере с компонентами 1С, включают автоматический REST-сервис и указывают состав доступных объектов. Затем клиент обращается к опубликованному URL и получает машиночитаемый ответ, например JSON. С помощью параметров запроса можно выбрать поля, задать фильтр и ограничить выдачу.
Уже на этапе публикации необходимо настроить аутентификацию, HTTPS и минимальные права. Для аналитического сценария разумен доступ только на чтение. Сам факт наличия URL не делает сервис безопасным для размещения в открытом интернете.
Первая проверка обычно отвечает на вопрос «Может ли агент получить данные?». Для эксплуатации важнее следующий: «Что произойдёт, когда запросы станут регулярными, разнообразными и одновременными?»
Сегодня агент скачал реализации за месяц. Завтра его попросят сравнить год с предыдущим, затем рассчитать средний чек, а после – проверить оборачиваемость и остатки. Меняются периоды, источники и состав полей. Если на каждый запрос агент заново читает продуктивную базу, одна и та же история извлекается многократно.
У рабочей 1С в это время собственные задачи: проведение документов, расчёты, работа пользователей и регламентные операции. Частые небольшие обращения способны создавать конкуренцию за ресурсы; один тяжёлый запрос может надолго занять процессор, дисковую подсистему или соединения. Поэтому оценивать нужно одновременно частоту запросов, их стоимость, объём читаемых данных и время выполнения.
Следующий естественный шаг – развернуть отдельную СУБД, например ClickHouse, и поручить агенту подготовить скрипт периодической загрузки из OData. Аналитические запросы в таком случае выполняются уже в хранилище. Это снимает часть повторной нагрузки, но оставляет нерешённой задачу обновления: как быстро и без полного перечитывания определить, что изменилось в 1С?
Инкрементальная загрузка предполагает, что сначала переносится исторический массив, а дальше – только новые, изменённые и удалённые данные. Для произвольного набора объектов 1С стандартный OData не предоставляет единого готового журнала всех изменений, который можно просто запросить «с момента предыдущей выгрузки». Логику обнаружения различий приходится проектировать отдельно.
Для документов скользящее окно кажется практичным решением. Можно каждый день перечитывать текущий месяц и часть предыдущего. Но бухгалтерия иногда исправляет документы более ранних периодов. Если дата документа осталась прежней и вышла за границу окна, корректировка не попадёт в хранилище. Дата документа сама по себе не равнозначна времени последнего изменения.
Со справочниками ситуация другая. Допустим, в номенклатуре сотни тысяч элементов. Вместо полного чтения всех атрибутов можно запросить идентификаторы и DataVersion, сравнить их с предыдущим состоянием и догрузить изменённые карточки. Передаваемых реквизитов меньше, но саму проверку большого набора выполнять всё равно нужно.
С регистрами сложнее. Записи движений могут зависеть от проведения или изменения документа-регистратора. При обновлении регистратора иногда требуется заново получить соответствующий набор движений, включая случай, когда прежняя запись больше не должна присутствовать в аналитической таблице. Простое добавление новых строк здесь легко приводит к двойному учёту.
Отдельный вопрос – физическое удаление и пометка на удаление: эти состояния нельзя автоматически считать одинаковыми. Правила отражения обоих событий в аналитическом приёмнике должны быть определены заранее.
На вебинаре обсуждались условные объёмы в 100–300 тысяч записей, при которых полное обновление ещё может оказаться приемлемым, и гораздо более крупные массивы, где его стоимость резко возрастает. Это ориентиры для обсуждения архитектуры, а не установленный технический лимит OData. Реальная граница зависит от объектов, фильтров, платформы, СУБД, оборудования, конкурентной нагрузки и требований к актуальности.
Если для выгрузки требуется сегментация, контроль версий, обработка удалений, повторные попытки, преобразование типов, расписание и мониторинг, вокруг простого API постепенно возникает самостоятельная интеграционная система. AI-агент способен помочь написать её скрипты. Но сгенерированный код придётся тестировать, сопровождать и проверять на корректность после изменений конфигурации 1С. Иначе команда получает набор процедур, чьи ошибки обнаруживаются уже в управленческих отчётах.
В показанном на вебинаре решении за извлечение отвечает Экстрактор 1С – расширение, установленное в информационной базе. Он позволяет выбрать источник, поля и приёмник, организовать историческую выгрузку и последующее инкрементальное обновление. В отличие от внешнего опроса через OData, механизм регистрации изменений работает на стороне 1С, используя события объектов и информацию о регистраторах.
Сначала крупный исторический объём разбивается на сегменты – например, по датам или другим признакам, подходящим выбранному объекту. Сегменты обрабатываются отдельными порциями, при необходимости параллельно. Размер пачки и количество потоков настраиваются с учётом производительности источника и приёмника. Максимальная параллельность без контроля может сама создать избыточную нагрузку на 1С.
После первичной загрузки Экстрактор регистрирует события изменения и формирует очередь заданий. В очереди фиксируется, какой объект или связанный набор данных необходимо обновить; для каждой операции не требуется хранить копию всей исторической таблицы. По расписанию обработчик получает актуальное состояние и отправляет его в приёмник.
Такой подход уменьшает число повторных чтений неизменившейся истории. При этом производительность и задержка остаются эксплуатационными характеристиками, которые необходимо измерять в конкретной информационной базе.
В демонстрации использовался регистр выручки и себестоимости, движения которого связаны с документами реализации. Спикер изменил документ реализации товаров и услуг. Экстрактор зарегистрировал событие, а в очереди появилась ссылка на соответствующий объект – реализацию № 2. После запуска проекта система прочитала актуальные данные по регистратору и отправила их в ClickHouse.
Смысл показанного механизма в адресности: чтобы актуализировать движения одного регистратора, не потребовалось заново сравнивать многолетнюю историю регистра через OData. При разработке конкретного проекта всё равно нужно проверить, как обрабатываются перепроведение, исчезновение движений и замена предыдущего набора строк в целевой таблице.
Экстрактор поддерживает работу с объектами конфигурации и режимы получения данных через запросы, подготовленные источники и обработчики. В рамках проекта можно выбрать реквизиты и табличные части, получить ключи ссылочных сущностей, добавить вычисляемые поля и служебные признаки, включая временные метки выгрузки. Эти сведения нужны, например, для связывания реализации с номенклатурой и контроля свежести данных.
Приёмником в вебинаре выступал ClickHouse. В презентации также указаны PostgreSQL, Microsoft SQL Server, MySQL и сценарии с Kafka. Для табличных приёмников Экстрактор может подготовить структуру, сопоставить типы и настроить параметры записи. Операции, зависящие от бизнес-логики 1С, уместно выполнить на стороне источника; тяжёлые объединения и аналитические расчёты лучше выносить в последующие слои обработки.
В презентации приведены показатели до 10 000 строк в секунду и интервал запуска от одной секунды. Это заявленные ориентиры возможностей продукта, а не результат универсального независимого теста и не гарантия секундной доставки при любых условиях. Проверять необходимо фактическую скорость, глубину очереди, время обновления витрин и влияние на рабочие операции.
Для управления выгрузками «Денвик Аналитика» использует MCP (Model Context Protocol). В показанной архитектуре агент через MCP-сервер получает доступ к разрешённым инструментам Экстрактора: чтению метаданных, выбору объектов, созданию проектов и запуску предусмотренных операций. Для этого используются дополнительный сервисный интерфейс Экстрактора и компоненты интеграции, размещаемые в инфраструктуре заказчика.
Агент выполняет роль интерпретатора задачи и координатора действий. Сами правила извлечения, сегментация, регистрация изменений и запись в СУБД выполняются Экстрактором. MCP передаёт команды инструментам; строки данных движутся по отдельному маршруту – из 1С через Экстрактор в хранилище. Это разграничение важно и для архитектуры, и для контроля доступа.
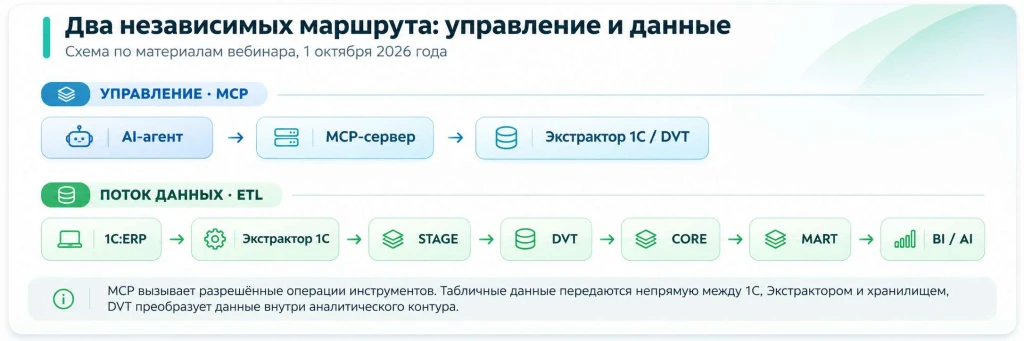
После ручной настройки и проверки обновления регистра спикер перешёл к сценарию с агентом. Команда была сформулирована простыми словами: «Выгрузи реализации». Через инструменты MCP агент обратился к метаданным 1С, определил подходящий документ и его структуру. В диалоге уточнялось, какие атрибуты выгружать, нужна ли товарная часть, куда направить результат и как выполнять проект.
Для демонстрации выбрали реализации вместе с товарными строками. В результате в ClickHouse появились две таблицы: одна с данными шапок документов, другая с позициями товаров, количеством, суммами и ссылками на исходные реализации. По этим ссылкам таблицы можно соединить для последующей аналитики.
Это показательный результат: агент помог создать реальные настройки выгрузки и получить структурированные данные в приёмнике. Вебинар при этом не демонстрировал законченный промышленный AI-сервис, который самостоятельно гарантирует правильность любых управленческих показателей.
В качестве агента в демонстрации использовался Claude; также сообщалось о тестировании сценариев с GPT/Codex. Интеграции с локальными и открытыми моделями обсуждались как направление развития. Их готовность для конкретного развёртывания нужно проверять отдельно.
Даже корректно выгруженные данные ещё не отвечают на вопрос «Какая у нас выручка?». В 1С сведения о продажах могут отражаться в документах, регистрах и подготовленных расчётных наборах. Если дать агенту произвольный доступ ко всем таблицам, он может выбрать неверный источник, ошибиться с детализацией или посчитать одну операцию дважды.
На вебинаре предложена многослойная модель хранилища:
Для построения преобразований «Денвик Аналитика» использует DVT – визуальный low-code ETL-инструмент. В нём связи, объединения, вычисления и переходы между слоями представлены графом операций. В материалах вебинара показана архитектурная роль DVT и описана возможность управления такими процессами через MCP; подробная самостоятельная демонстрация построения витрин была обозначена как следующая тема.
Предположим, руководитель спрашивает, почему упала прибыль. Агенту нужно знать, какой показатель компания называет прибылью, за какой период его считать, какие организации и статусы документов учитывать и в какой витрине содержится согласованный результат. Названия колонок не дают всех этих ответов.
Поэтому рядом с аналитической моделью нужны определения метрик, описание источников, связи между бизнес-понятиями, правила доступа и контроль качества. Агенту лучше разрешать чтение согласованных витрин MART, а не всех таблиц STAGE и CORE. Тогда BI-отчёт и ответ на естественном языке могут опираться на один источник расчёта. Вычисления агента всё равно следует проверять, особенно если результат влияет на финансовое или операционное решение.
Прямой доступ агента к OData рабочей базы допустим только в границах утверждённых прав и сетевой политики. При использовании внешней языковой модели отдельно проверяют, какие схемы, метаданные, параметры запросов и фрагменты данных передаются поставщику. Перенос извлечения в собственное хранилище даёт больше возможностей ограничить набор дÐ
На вебинаре «LLM + OData + 1С: выдержит ли рабочая база AI-аналитику?», состоявшемся 1 октября 2026 года, технический директор «Денвик Аналитики» Степан Пыстин разобрал путь от прямых запросов к 1С через OData до отдельного контура данных с инкрементальной выгрузкой, ClickHouse и управлением через MCP. Разбираем техническую механику этого подхода и результаты показанной демонстрации.
Короткий ответ: OData подходит для адресных запросов и ограниченных интеграций. Когда AI-аналитике нужны большие исторические объёмы, регулярные обновления и множество пользователей, разумно вынести аналитическую нагрузку за пределы рабочей 1С. В показанной архитектуре Экстрактор 1С передаёт изменения в хранилище, DVT подготавливает данные, а AI-агент через MCP помогает управлять настройкой процессов и работать с согласованными витринами.
Почему прямой OData быстро усложняется
Первый запрос выглядит убедительно
Представим обычный сценарий: руководитель пишет агенту «Посчитай сумму продаж за октябрь». Агент находит подходящие объекты 1С, запрашивает записи реализации, получает данные, вычисляет итог и возвращает таблицу или график. Пользователю не нужно разбираться в структуре базы и писать запрос самостоятельно.
Для такого взаимодействия в 1С можно опубликовать стандартный интерфейс OData. Информационную базу размещают на веб-сервере с компонентами 1С, включают автоматический REST-сервис и указывают состав доступных объектов. Затем клиент обращается к опубликованному URL и получает машиночитаемый ответ, например JSON. С помощью параметров запроса можно выбрать поля, задать фильтр и ограничить выдачу.
Уже на этапе публикации необходимо настроить аутентификацию, HTTPS и минимальные права. Для аналитического сценария разумен доступ только на чтение. Сам факт наличия URL не делает сервис безопасным для размещения в открытом интернете.
Первая проверка обычно отвечает на вопрос «Может ли агент получить данные?». Для эксплуатации важнее следующий: «Что произойдёт, когда запросы станут регулярными, разнообразными и одновременными?»
Почему повторные вопросы создают новую нагрузку
Сегодня агент скачал реализации за месяц. Завтра его попросят сравнить год с предыдущим, затем рассчитать средний чек, а после – проверить оборачиваемость и остатки. Меняются периоды, источники и состав полей. Если на каждый запрос агент заново читает продуктивную базу, одна и та же история извлекается многократно.
У рабочей 1С в это время собственные задачи: проведение документов, расчёты, работа пользователей и регламентные операции. Частые небольшие обращения способны создавать конкуренцию за ресурсы; один тяжёлый запрос может надолго занять процессор, дисковую подсистему или соединения. Поэтому оценивать нужно одновременно частоту запросов, их стоимость, объём читаемых данных и время выполнения.
Следующий естественный шаг – развернуть отдельную СУБД, например ClickHouse, и поручить агенту подготовить скрипт периодической загрузки из OData. Аналитические запросы в таком случае выполняются уже в хранилище. Это снимает часть повторной нагрузки, но оставляет нерешённой задачу обновления: как быстро и без полного перечитывания определить, что изменилось в 1С?
Где ломается инкремент через OData
Инкрементальная загрузка предполагает, что сначала переносится исторический массив, а дальше – только новые, изменённые и удалённые данные. Для произвольного набора объектов 1С стандартный OData не предоставляет единого готового журнала всех изменений, который можно просто запросить «с момента предыдущей выгрузки». Логику обнаружения различий приходится проектировать отдельно.
Четыре стратегии для разных объектов
| Данные 1С | Возможный способ обновления через OData | Что остаётся проблемой |
|---|---|---|
| Документы | Повторно читать скользящий период по дате документа | Изменение старого документа за пределами окна останется незамеченным |
| Справочники | Сопоставлять идентификаторы и DataVersion, затем перечитывать изменённые элементы | Для поиска различий приходится опрашивать большой список ключей и версий |
| Регистры | Выявлять изменения документов-регистраторов и обновлять связанные движения | Логика зависит от регистра и связи с регистраторами; универсальной версии строки нет |
| Удаления | Периодически сверять ключи источника и приёмника | Для обнаружения отсутствующих объектов нужны дополнительные обходы и согласование правил удаления |
Для документов скользящее окно кажется практичным решением. Можно каждый день перечитывать текущий месяц и часть предыдущего. Но бухгалтерия иногда исправляет документы более ранних периодов. Если дата документа осталась прежней и вышла за границу окна, корректировка не попадёт в хранилище. Дата документа сама по себе не равнозначна времени последнего изменения.
Со справочниками ситуация другая. Допустим, в номенклатуре сотни тысяч элементов. Вместо полного чтения всех атрибутов можно запросить идентификаторы и DataVersion, сравнить их с предыдущим состоянием и догрузить изменённые карточки. Передаваемых реквизитов меньше, но саму проверку большого набора выполнять всё равно нужно.
С регистрами сложнее. Записи движений могут зависеть от проведения или изменения документа-регистратора. При обновлении регистратора иногда требуется заново получить соответствующий набор движений, включая случай, когда прежняя запись больше не должна присутствовать в аналитической таблице. Простое добавление новых строк здесь легко приводит к двойному учёту.
Отдельный вопрос – физическое удаление и пометка на удаление: эти состояния нельзя автоматически считать одинаковыми. Правила отражения обоих событий в аналитическом приёмнике должны быть определены заранее.
Почему нельзя назвать один «предел строк»
На вебинаре обсуждались условные объёмы в 100–300 тысяч записей, при которых полное обновление ещё может оказаться приемлемым, и гораздо более крупные массивы, где его стоимость резко возрастает. Это ориентиры для обсуждения архитектуры, а не установленный технический лимит OData. Реальная граница зависит от объектов, фильтров, платформы, СУБД, оборудования, конкурентной нагрузки и требований к актуальности.
Если для выгрузки требуется сегментация, контроль версий, обработка удалений, повторные попытки, преобразование типов, расписание и мониторинг, вокруг простого API постепенно возникает самостоятельная интеграционная система. AI-агент способен помочь написать её скрипты. Но сгенерированный код придётся тестировать, сопровождать и проверять на корректность после изменений конфигурации 1С. Иначе команда получает набор процедур, чьи ошибки обнаруживаются уже в управленческих отчётах.
Как Экстрактор 1С обрабатывает изменения
Первичная загрузка и очередь событий
В показанном на вебинаре решении за извлечение отвечает Экстрактор 1С – расширение, установленное в информационной базе. Он позволяет выбрать источник, поля и приёмник, организовать историческую выгрузку и последующее инкрементальное обновление. В отличие от внешнего опроса через OData, механизм регистрации изменений работает на стороне 1С, используя события объектов и информацию о регистраторах.
Сначала крупный исторический объём разбивается на сегменты – например, по датам или другим признакам, подходящим выбранному объекту. Сегменты обрабатываются отдельными порциями, при необходимости параллельно. Размер пачки и количество потоков настраиваются с учётом производительности источника и приёмника. Максимальная параллельность без контроля может сама создать избыточную нагрузку на 1С.
После первичной загрузки Экстрактор регистрирует события изменения и формирует очередь заданий. В очереди фиксируется, какой объект или связанный набор данных необходимо обновить; для каждой операции не требуется хранить копию всей исторической таблицы. По расписанию обработчик получает актуальное состояние и отправляет его в приёмник.
Такой подход уменьшает число повторных чтений неизменившейся истории. При этом производительность и задержка остаются эксплуатационными характеристиками, которые необходимо измерять в конкретной информационной базе.
Что происходит с регистрами
В демонстрации использовался регистр выручки и себестоимости, движения которого связаны с документами реализации. Спикер изменил документ реализации товаров и услуг. Экстрактор зарегистрировал событие, а в очереди появилась ссылка на соответствующий объект – реализацию № 2. После запуска проекта система прочитала актуальные данные по регистратору и отправила их в ClickHouse.
Смысл показанного механизма в адресности: чтобы актуализировать движения одного регистратора, не потребовалось заново сравнивать многолетнюю историю регистра через OData. При разработке конкретного проекта всё равно нужно проверить, как обрабатываются перепроведение, исчезновение движений и замена предыдущего набора строк в целевой таблице.
Какие данные можно подготовить
Экстрактор поддерживает работу с объектами конфигурации и режимы получения данных через запросы, подготовленные источники и обработчики. В рамках проекта можно выбрать реквизиты и табличные части, получить ключи ссылочных сущностей, добавить вычисляемые поля и служебные признаки, включая временные метки выгрузки. Эти сведения нужны, например, для связывания реализации с номенклатурой и контроля свежести данных.
Приёмником в вебинаре выступал ClickHouse. В презентации также указаны PostgreSQL, Microsoft SQL Server, MySQL и сценарии с Kafka. Для табличных приёмников Экстрактор может подготовить структуру, сопоставить типы и настроить параметры записи. Операции, зависящие от бизнес-логики 1С, уместно выполнить на стороне источника; тяжёлые объединения и аналитические расчёты лучше выносить в последующие слои обработки.
В презентации приведены показатели до 10 000 строк в секунду и интервал запуска от одной секунды. Это заявленные ориентиры возможностей продукта, а не результат универсального независимого теста и не гарантия секундной доставки при любых условиях. Проверять необходимо фактическую скорость, глубину очереди, время обновления витрин и влияние на рабочие операции.
Что AI-агент делает через MCP
У модели появляется определённый набор инструментов
Для управления выгрузками «Денвик Аналитика» использует MCP (Model Context Protocol). В показанной архитектуре агент через MCP-сервер получает доступ к разрешённым инструментам Экстрактора: чтению метаданных, выбору объектов, созданию проектов и запуску предусмотренных операций. Для этого используются дополнительный сервисный интерфейс Экстрактора и компоненты интеграции, размещаемые в инфраструктуре заказчика.
Агент выполняет роль интерпретатора задачи и координатора действий. Сами правила извлечения, сегментация, регистрация изменений и запись в СУБД выполняются Экстрактором. MCP передаёт команды инструментам; строки данных движутся по отдельному маршруту – из 1С через Экстрактор в хранилище. Это разграничение важно и для архитектуры, и для контроля доступа.
Что было показано на вебинаре
После ручной настройки и проверки обновления регистра спикер перешёл к сценарию с агентом. Команда была сформулирована простыми словами: «Выгрузи реализации». Через инструменты MCP агент обратился к метаданным 1С, определил подходящий документ и его структуру. В диалоге уточнялось, какие атрибуты выгружать, нужна ли товарная часть, куда направить результат и как выполнять проект.
Для демонстрации выбрали реализации вместе с товарными строками. В результате в ClickHouse появились две таблицы: одна с данными шапок документов, другая с позициями товаров, количеством, суммами и ссылками на исходные реализации. По этим ссылкам таблицы можно соединить для последующей аналитики.
Это показательный результат: агент помог создать реальные настройки выгрузки и получить структурированные данные в приёмнике. Вебинар при этом не демонстрировал законченный промышленный AI-сервис, который самостоятельно гарантирует правильность любых управленческих показателей.
В качестве агента в демонстрации использовался Claude; также сообщалось о тестировании сценариев с GPT/Codex. Интеграции с локальными и открытыми моделями обсуждались как направление развития. Их готовность для конкретного развёртывания нужно проверять отдельно.
Как готовятся данные для AI
От сырых таблиц к проверяемым показателям
Даже корректно выгруженные данные ещё не отвечают на вопрос «Какая у нас выручка?». В 1С сведения о продажах могут отражаться в документах, регистрах и подготовленных расчётных наборах. Если дать агенту произвольный доступ ко всем таблицам, он может выбрать неверный источник, ошибиться с детализацией или посчитать одну операцию дважды.
На вебинаре предложена многослойная модель хранилища:
- STAGE – извлечённые из 1С данные с минимальной обработкой. Здесь сохраняются исходные идентификаторы и признаки, необходимые для проверки полноты и последующих преобразований.
- CORE – согласованные сущности: приведённые типы, связи объектов, правила обработки ссылок и очищенные наборы. Здесь техническая структура приближается к общей модели предметной области.
- MART – витрины для конкретных аналитических задач. В них закрепляют определения показателей, зерно расчёта, нужные агрегаты и допустимый состав данных для потребителей.
Для построения преобразований «Денвик Аналитика» использует DVT – визуальный low-code ETL-инструмент. В нём связи, объединения, вычисления и переходы между слоями представлены графом операций. В материалах вебинара показана архитектурная роль DVT и описана возможность управления такими процессами через MCP; подробная самостоятельная демонстрация построения витрин была обозначена как следующая тема.
Почему бизнес-глоссарий важнее красивого ответа
Предположим, руководитель спрашивает, почему упала прибыль. Агенту нужно знать, какой показатель компания называет прибылью, за какой период его считать, какие организации и статусы документов учитывать и в какой витрине содержится согласованный результат. Названия колонок не дают всех этих ответов.
Поэтому рядом с аналитической моделью нужны определения метрик, описание источников, связи между бизнес-понятиями, правила доступа и контроль качества. Агенту лучше разрешать чтение согласованных витрин MART, а не всех таблиц STAGE и CORE. Тогда BI-отчёт и ответ на естественном языке могут опираться на один источник расчёта. Вычисления агента всё равно следует проверять, особенно если результат влияет на финансовое или операционное решение.
Безопасность, ограничения и практический запуск
Прямой доступ агента к OData рабочей базы допустим только в границах утверждённых прав и сетевой политики. При использовании внешней языковой модели отдельно проверяют, какие схемы, метаданные, параметры запросов и фрагменты данных передаются поставщику. Перенос извлечения в собственное хранилище даёт больше возможностей ограничить набор дÐ