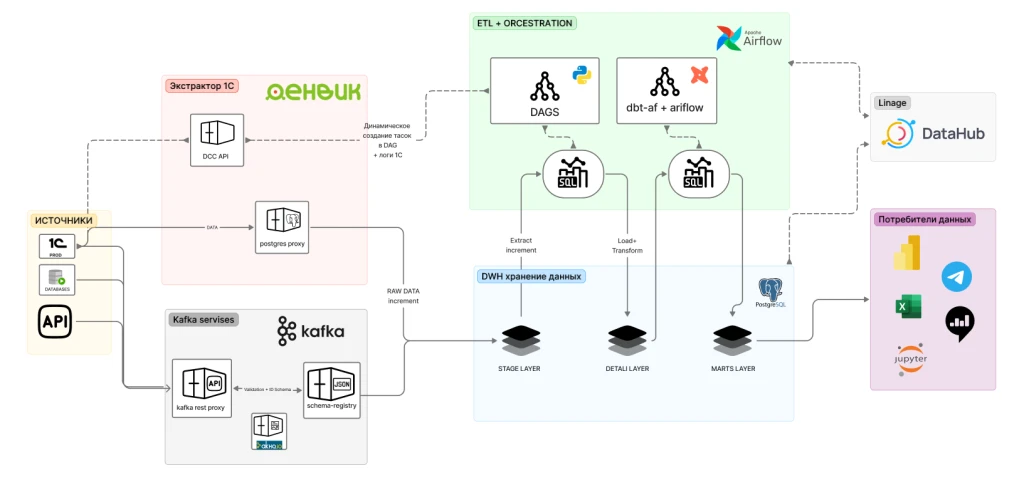
Первым важным шагом стало создание стейдж-слоя (Staging). Нам нужно было устранить фундаментальную проблему прошлого – отсутствие инкрементальной выгрузки из 1С.
Полный пересчет базы больше не был приемлемым вариантом.
Мы быстро поняли, что писать свой надежный механизм CDC (Change Data Capture) для 1С с нуля — это месяцы разработки, тестирования и отладки краевых сценариев. Бизнес не готов был столько ждать.
Поэтому мы пошли по пути использования готового решения и выбрали инструмент "Экстрактор 1С в BI" от "Денвик Аналитики", который стал основой новой архитектуры.
Почему именно этот инструмент?
- Инкрементальность: Инструмент умеет отслеживать изменения в 1С, включая корректировки задним числом, и выгружает в стейдж только дельты (новые и измененные записи). Это решило ключевую проблему старой системы.
- Удобство настройки: Выгрузка больше не требует сложных SQL-скриптов. Таблицы и поля для стейджа настраиваются через понятный интерфейс, что ускоряет и упрощает процесс.
Преимущества для базового слоя:
- Снижение нагрузки: Минимальное воздействие на рабочую систему 1С и сеть, так как выгружаются только изменения.
- Скорость: Выгрузка дельт занимает минуты или десятки минут вместо часов.
- Стабильность: Процесс стал более предсказуемым и надежным.
- Технология стейджа: Мы выбрали PostgreSQL – надежное и хорошо интегрируемое решение. Данные из 1С через Экстрактор 1С поступают сюда в "сыром" виде, но уже с возможностью инкрементального обновления.
Сердце системы: DDS-слой и Airflow – порядок и управление данными
Стейдж-слой – это только начало. Нам требовался следующий уровень, где "сырые" инкрементальные данные превращаются в чистые, согласованные бизнес-сущности с сохранением истории изменений.
Так появился DDS (Detail Data Store) слой, также реализованный на PostgreSQL.
Задачи DDS:
- Уникальные идентификаторы: Каждой сущности (заказ, клиент, товар) присваивается неизменяемый ID, понятный бизнесу (суррогатный или стабильный бизнес-ключ).
- Очистка и стандартизация: Приведение данных к единым форматам, устранение несоответствий.
- Сохранение истории: Использование Slowly Changing Dimensions Type 2 (SCD2) для ключевых атрибутов (например, изменение статуса заказа или цены товара), чтобы отслеживать, когда и что именно изменилось.
Инструмент оркестрации: Apache Airflow. Почему именно он?
- Централизованное управление: Весь процесс преобразования данных из стейджа в DDS управляется через единый DAG (Directed Acyclic Graph) в Airflow.
- Принципы обработки:
- Инкрементальность: Обрабатываются только новые или измененные данные из стейджа (благодаря дельтам от данного продукта), что обеспечивает масштабируемость при росте объемов.
- Эффективность: Один DAG управляет обновлением около 50 таблиц в DDS-слое. Логика структурирована внутри DAG, что упрощает контроль и делает процесс более прозрачным по сравнению с разрозненными скриптами или проектами KNIME.
- Надежность: Airflow предоставляет инструменты для мониторинга, алертинга и повторного выполнения задач, гарантируя успешное завершение процессов.
Результат DDS-слоя: Чистые, согласованные бизнес-сущности с уникальными ID и полной историей изменений (SCD2), готовые для построения аналитических витрин. Это стало основой для качества и доверия к данным.
Выбор Airflow – это только первый шаг. Чтобы обеспечить надежность и плавное внедрение изменений в DDS-слой, мы разработали структурированный процесс разработки и деплоя:
Две изолированные среды:
- Airflow-TEST: Развернута на Docker. Это среда для разработки и тестирования новых DAG'ов или изменений в существующих. Здесь можно безопасно проверять логику и выполнение задач на тестовых данных.
- Airflow-PROD: Также на Docker, но на отдельном, более мощном сервере. Это рабочая среда, отвечающая за регулярное обновление DDS-слоя. Её стабильность имеет критическое значение.
Процесс разработки и деплоя (CI/CD через GitLab):
- Шаг 1: Разработка или изменение DAG. Инженер создает новый DAG или вносит правки в существующий в своей локальной среде или отдельной ветке Git.
- Шаг 2: Тестирование на Airflow-TEST. Обновленный код отправляется в GitLab. Airflow-TEST обновляется из этой ветки (автоматически или вручную). Инженер проверяет выполнение DAG на тестовых данных, анализирует логи, убеждается, что логика работает корректно, не нарушает существующие таблицы и эффективно обрабатывает инкрементальные данные.
- Шаг 3: Код-ревью и слияние. После успешного тестирования код проходит проверку коллегами. После подтверждения качества изменения сливаются в основную ветку репозитория (например, main или master), где хранится код Airflow (DAG'и, скрипты, конфигурации).
- Шаг 4: Автоматический CI/CD на PROD. Срабатывает пайплайн GitLab CI/CD, который: Собирает новый Docker-образ для Airflow-PROD с актуальным кодом из основной ветки. Разворачивает этот образ на продакшен-сервере Airflow-PROD. Старый контейнер останавливается, а новый запускается с обновленными DAG'ами.
- Шаг 5: Мониторинг PROD. После деплоя мы следим за выполнением DAG'ов в Airflow-PROD, особенно в первые запуски после изменений. Airflow предоставляет инструменты для мониторинга и уведомлений о проблемах.
Преимущества такого подхода:
- Быстрое и безопасное внедрение изменений: Тестирование в изолированной TEST-среде снижает риск ошибок на продакшене.
- Надежность PROD: Автоматизированный CI/CD-пайплайн гарантирует, что на продакшене используется только проверенный код из основной ветки. Ручное вмешательство минимизировано.
- Удобство тестирования: Разработчики могут экспериментировать и проверять идеи в TEST-среде без риска для основной системы.
- Контроль версий и история: Код Airflow (DAG'и) хранится в GitLab, что обеспечивает полную историю изменений, возможность отката и совместную работу.
- Управление через Docker: Контейнеризация упрощает развертывание, изоляцию сред и переносимость.
Итог: Процесс работы с Airflow – это не просто запуск DAG'ов, а полноценный инженерный цикл (Dev/Test/Deploy), основанный на принципах CI/CD и разделения сред.
Это обеспечивает надежность и скорость разработки, которые были заложены в цели новой архитектуры.
Изменения в DDS-слое вносятся быстро и предсказуемо.
 Почему это эффективно:
- Четкая последовательность: Описан пошаговый процесс от разработки до деплоя.
- Фокус на изоляции: Разделение TEST и PROD сред – основа безопасности.
- Детали CI/CD: Указаны конкретные шаги пайплайна (сборка образа, деплой).
- Связь с целями: Подчеркнуто, как процесс поддерживает надежность и скорость разработки.
- Инструменты: Упоминание Docker, GitLab и CI/CD делает описание понятным для технической аудитории.
- Профессиональный подход: Показана зрелость процесса, который не строится на импровизации.
- Логика повествования: Это естественное продолжение истории о создании надежной системы.
Результат реализации:
Мы превратили Airflow в надежный инструмент управления процессами. Благодаря докеризации, разделению сред TEST/PROD, автоматизации CI/CD и контролю версий через GitLab, мы можем быстро и безопасно развивать DDS-слой – добавлять новые сущности, улучшать логику SCD2 или оптимизировать обработку данных без риска для продакшена.
Это полная противоположность сложностям поддержки прежних решений.
Сравнение с прошлым:
|
Критерий
|
Раньше (KNIME/SQL)
|
Сейчас (Airflow + CI/CD)
|
|
Тестирование
|
Практически невозможно, "на проде"
|
Изолированная среда Airflow-TEST
|
|
Деплой
|
Ручное копирование скриптов
|
Автоматический CI/CD через GitLab
|
|
Воспроизводимость
|
Зависимость от локальных настроек
|
Docker-образы + контроль версий
|
|
Надежность
|
Частые сбои при обновлениях
|
Стабильный процесс с откатом
|
|
Скорость изменений
|
Дни или недели
|
Часы (от теста до продакшена)
|
Пример для понимания:
Раньше добавление новой таблицы в DDS требовало нескольких дней работы над сложным скриптом с высоким риском ошибок.
Теперь процесс выглядит так:
- Создание DAG: один день.
-
Тестирование на Airflow-TEST: пару часов.
-
Отправка кода в GitLab: 20 минут.
-
Запуск на продакшене: код уже работает.
-
Доступ аналитиков: на следующее утро.
Этот подход создает основу для следующего этапа – внедрения dbt для работы с витринами.
Реальный эффект:
- Сокращение времени разработки с нескольких дней до 24 часов.
-
Минимизация риска ошибок благодаря тестированию.
-
Быстрое внедрение изменений и доступ к новым данным для аналитиков.
-
Создание основы для дальнейшего внедрения dbt и оптимизации работы с витринами данных.
 Назад