Назад
В 1С накоплены продажи, остатки, движения товаров, данные клиентов и история операций.
Большинство привычных вопросов к этой информации закрываются отчётами:
Но есть другой класс вопросов.
Какие товары систематически покупают вместе? Какие действия клиентов образуют повторяющиеся последовательности? Можно ли разделить покупателей на группы без заранее заданных сегментов? Какие характеристики связаны с определённым результатом?
Для таких задач в платформе 1С существует отдельный механизм «Анализ данных и прогнозирование».
Он предназначен не столько для вывода уже известного KPI, сколько для исследования выборки и поиска закономерностей.
Официальная документация 1С также предусматривает использование результатов анализа для последующего построения моделей прогноза.
Но наличие алгоритма внутри платформы ещё не означает, что любой аналитический сценарий разумно решать внутри одной информационной базы.
Разберём сначала сами методы, а затем проведём эту границу.
Отчёт начинается с известного вопроса.
Например:
Какая выручка была в июле? Система получает данные, группирует их и выводит результат. Механизм анализа данных начинается с другой постановки: Какие закономерности существуют в этой выборке? Поэтому отчёты, СКД и анализ данных не являются взаимозаменяемыми инструментами.
Здесь лучше сначала определить вопрос и только затем выбирать метод.
В платформе механизм представлен набором взаимодействующих объектов встроенного языка. Разработчик может использовать их внутри прикладного решения, управлять параметрами анализа программно и получать программный доступ к результату.
Общая последовательность выглядит так:
источник данных → выборка → метод анализа → результат → интерпретация → при необходимости модель прогноза
При этом результат не нужно автоматически считать готовым бизнес-решением.
Если алгоритм обнаружил связь между двумя признаками, ещё требуется ответить:
Смысл анализа появляется не в момент запуска алгоритма, а после интерпретации результата.
Платформа поддерживает пять основных типов:
Именно такой набор описывает официальная документация 1С.
Общая статистика нужна для первоначального исследования выборки.
До поиска сложных закономерностей аналитику полезно понять сами данные:
Официальное описание отдельно разделяет непрерывные и дискретные поля.
К непрерывным относятся, например, числа и даты.
Представим клиентскую базу.
До кластеризации можно проверить:
Так становится понятнее, какие характеристики вообще имеют смысл для последующей сегментации.
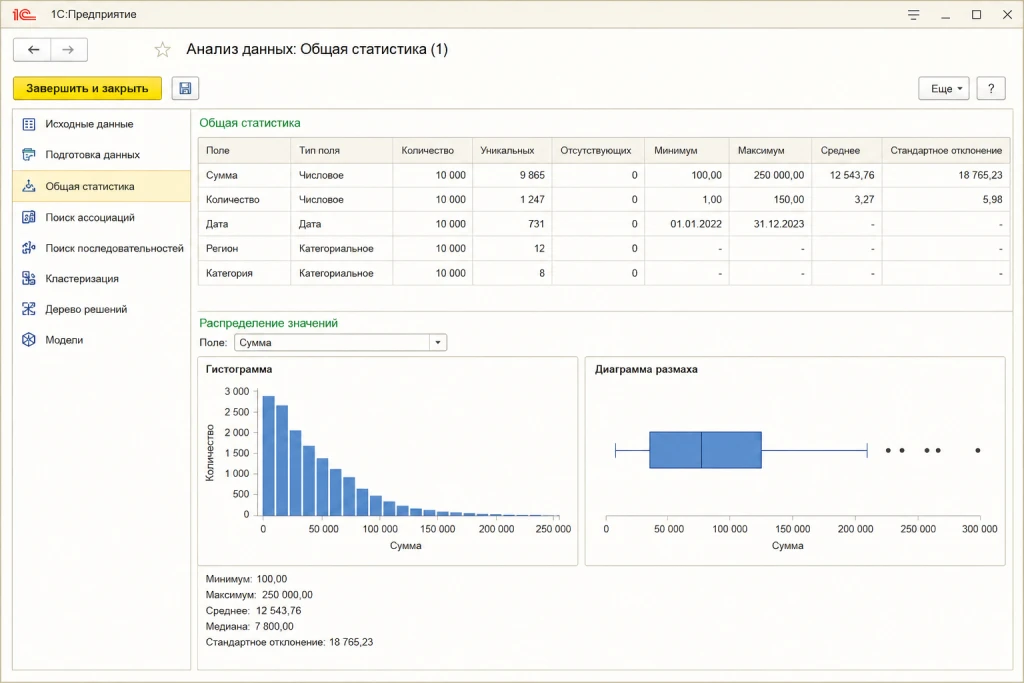
Пример предварительного исследования выборки средствами анализа данных 1С.
Ассоциативный анализ ищет объекты или значения, которые регулярно встречаются вместе.
Классический пример: покупатель добавил в заказ товар А — какие товары часто встречаются в тех же заказах?
Результатом могут стать устойчивые сочетания и ассоциативные правила.
Официальный механизм также умеет учитывать иерархические данные. Поэтому закономерность можно искать не только между конкретными товарами, но и между товарными группами.
Это расширяет область применения.
Например, можно анализировать:
Но обнаруженная совместная встречаемость сама по себе ещё не доказывает причинную связь.
Если два товара регулярно оказываются в одном заказе, это не означает, что продажа первого вызывает продажу второго. Возможна третья причина: сезонность, акция, специфика группы покупателей.
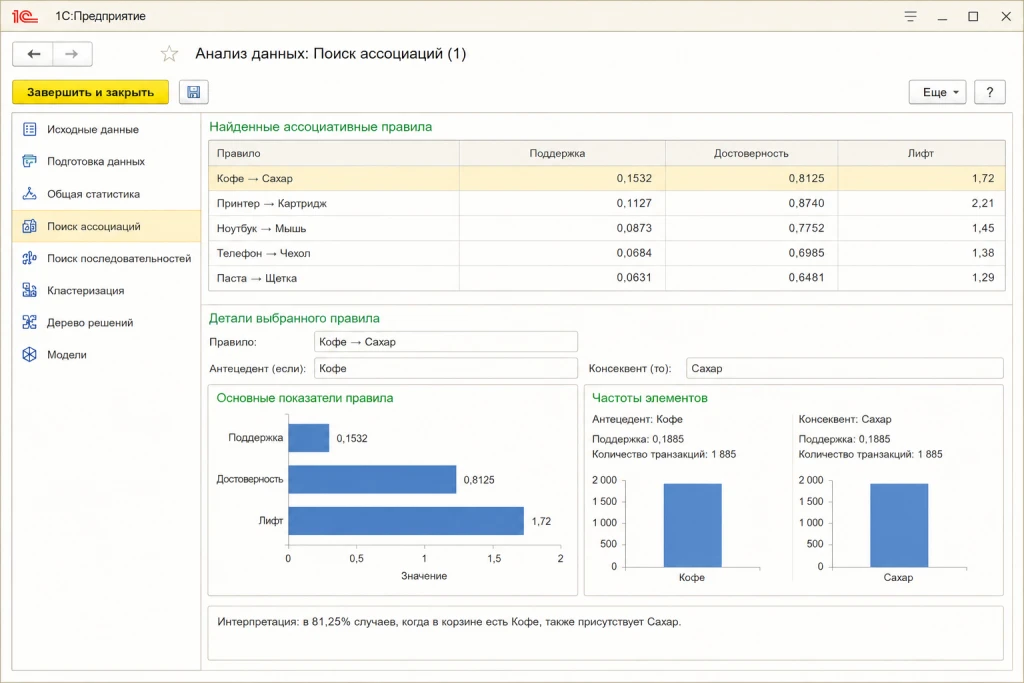
Пример ассоциативных правил: система ищет значения, которые регулярно встречаются совместно.
Здесь важен уже не только набор событий, но и их порядок.
Ассоциация отвечает:
Что встречается вместе?
Последовательность:
Что обычно происходит после чего?
Например, можно исследовать историю заказов клиентов и искать цепочки:
товар А → через определённый период товар Б → затем товар В
Платформа даёт возможность ограничивать временные расстояния между событиями и регулировать параметры результата.
Такая постановка подходит для:
Порядок здесь принципиален.
Если клиент покупает три товара в любой комбинации, это ассоциация. Если нас интересует устойчивая очередность их приобретения, это уже последовательность.
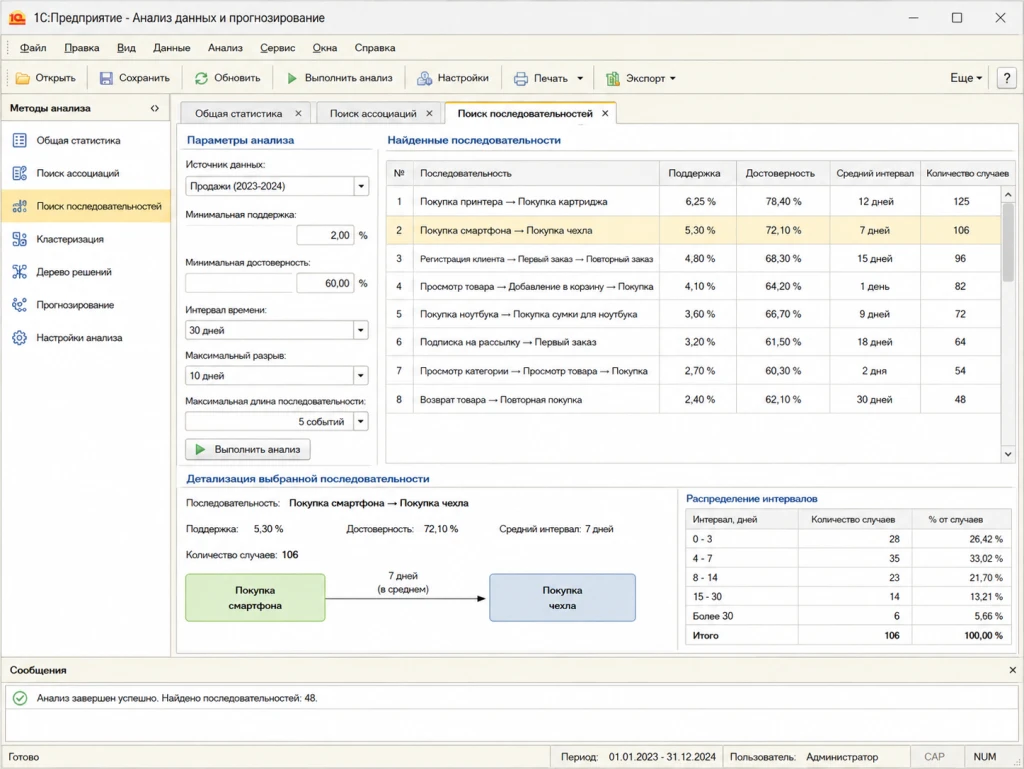
Пример анализа цепочек событий средствами 1С.
Кластеризация решает другую задачу: пытается разделить объекты на группы по сходству признаков.
Главное отличие от обычной сегментации - группы не задаются заранее.
Допустим, есть несколько тысяч клиентов и набор характеристик:
VIP / постоянные / новые / уходящие.
А можно сначала посмотреть, какие группы формируются из самих данных.
Официальный механизм 1С даёт возможность выбирать характеристики, изменять их состав и задавать весовые коэффициенты. Результат может отображаться в форме дендрограммы.
После кластеризации начинается наиболее содержательная часть работы - интерпретация.
Система может сформировать три или пять групп, но назвать их «ключевые клиенты» или «группа риска» уже должен аналитик на основании характеристик каждого кластера.
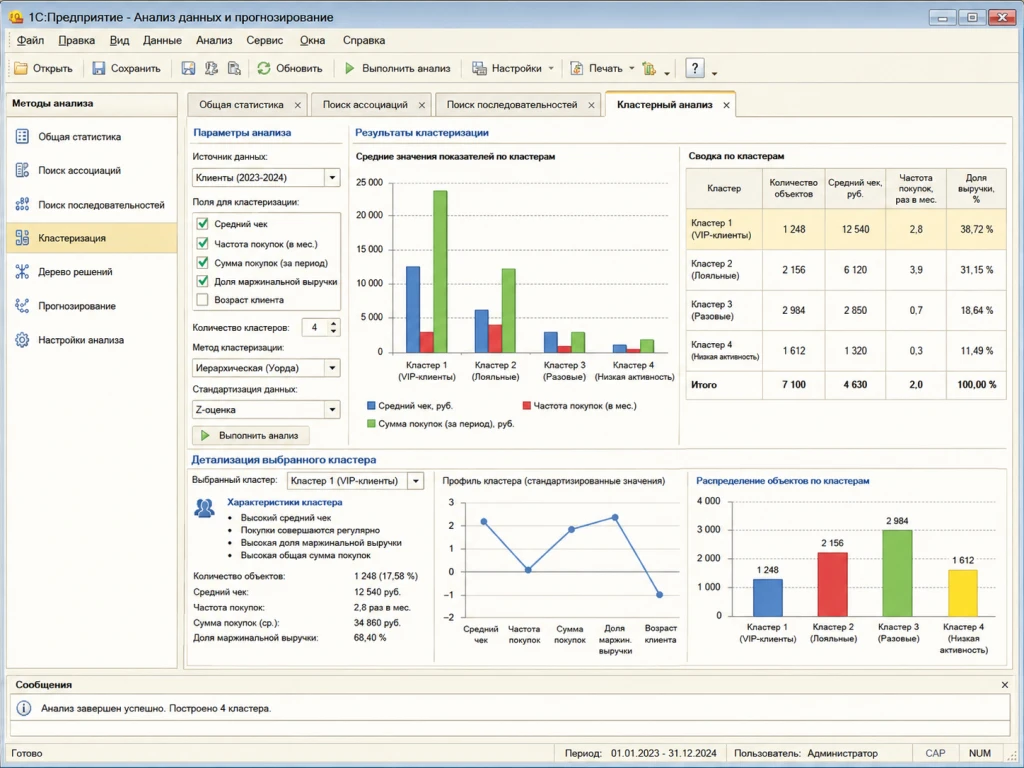
Пример разделения объектов на группы по сходству признаков.
Дерево решений используется, когда есть целевой признак и требуется найти набор правил, связанных с ним.
Представим историю сделок.
Для каждой известно:
Можно поставить задачу:
Какие сочетания характеристик связаны с успешным завершением сделки?
Алгоритм формирует иерархическую структуру условий.
Официальное описание 1С приводит аналогичную механику: выбирается целевой атрибут и набор входных признаков, после чего результат строится как дерево классифицирующих правил.
Сильная сторона такого результата - интерпретируемость.
Вместо одного непрозрачного коэффициента пользователь видит последовательность:
если условие А → затем Б → результат относится к определённому классу
Но и здесь нельзя автоматически превращать найденное правило в управленческий вывод.
Сначала нужно проверить качество исходных данных и устойчивость классификации.
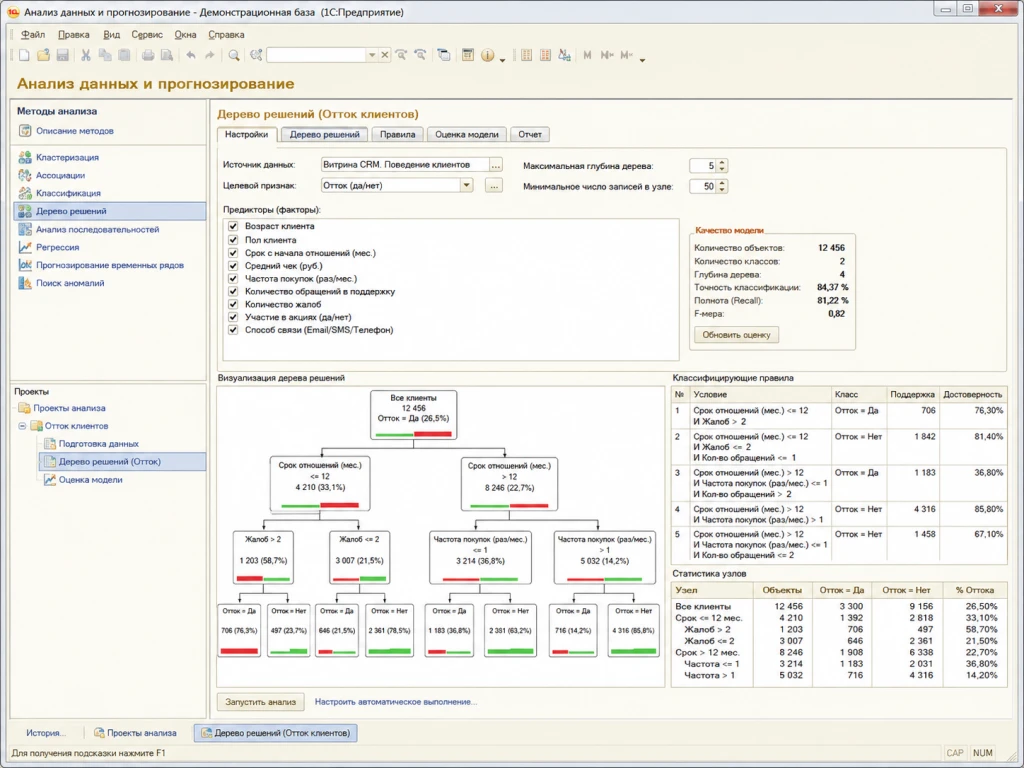
Пример классифицирующих правил, сформированных методом дерева решений.
Полезнее выбирать не алгоритм, а тип вопроса.
Эту последовательность можно использовать и как диагностический фильтр.
Если вопрос звучит: сколько было продаж? вам вообще не нужен этот механизм.
Если: какие клиенты похожи друг на друга по совокупности поведения? это уже задача кластеризации.
Да, но слово «прогнозирование» здесь нужно понимать точно.
Результат выполненного анализа может использоваться для формирования модели, которую затем применяют к новым данным. Официальная документация описывает, например, сценарий, когда найденные ассоциации используются для прогнозирования сопутствующих товаров в новой покупке.
Это не означает, что внутри 1С находится универсальная ML-платформа для любой задачи прогнозирования.
Сначала нужно получить пригодную модель средствами конкретного метода.
Например:
история покупок → поиск ассоциаций → модель → новая покупка → предполагаемые сопутствующие товары
или:
история объектов → дерево решений → модель классификации → новый объект → предполагаемый класс
Наличие метода не компенсирует плохую подготовку данных.
Если в источнике:
Поэтому разумная последовательность выглядит так:
Сам механизм реализован на уровне объектов встроенного языка. Разработчик может использовать эти объекты в прикладном решении и формировать собственный пользовательский сценарий.
Поэтому ситуация зависит от конфигурации.
Если нужный механизм уже встроен в прикладной интерфейс, пользователь может работать с подготовленным сценарием.
Если требуется:
Это одна из причин, почему вопрос нужно формулировать не так: Есть ли в 1С кластеризация?
а так: Насколько трудоёмко реализовать требуемый аналитический сценарий в нашем конкретном контуре?
До этого момента мы говорили об алгоритмах. Но в корпоративной аналитике проблема нередко возникает уровнем выше — в архитектуре данных.
Представим, что продажи находятся в ERP, клиентская активность — в CRM, маркетинговые расходы — во внешнем сервисе, а часть финансовых данных — ещё в одной базе 1С.
Тогда главный вопрос уже не: Какой вид анализа выбрать? А: Как получить согласованный набор данных для анализа?
Именно здесь проходит граница между локальной аналитической задачей внутри одной информационной базы и корпоративным аналитическим контуром.
Встроенный механизм хорошо подходит, когда:
Отдельный контур данных становится оправданным, когда:
Это уже другая архитектурная задача.
Для такого сценария разделяются получение, преобразование, хранение и визуализация данных.
Например:
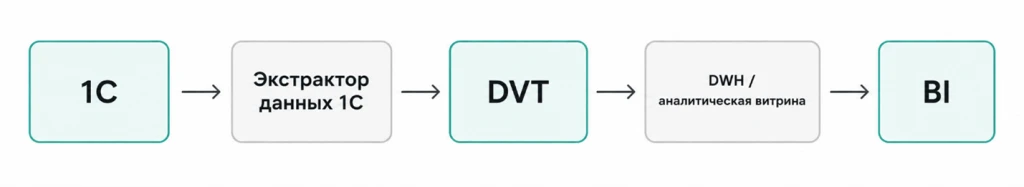
Если баз 1С несколько:
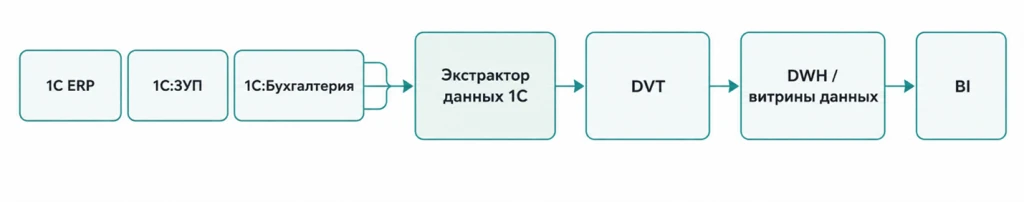
Экстрактор используется для получения данных из одной или нескольких информационных баз 1С и передачи их во внешний слой.
Это отделяет задачу извлечения данных от аналитической логики.
DVT подключается, когда данные нужно:
То есть решение переносится из логики: «построить ещё один сложный отчёт внутри каждой базы» в логику: «собрать единый слой данных, на котором работают разные аналитические сценарии».
Как понять, нужен ли внешний контур
Можно использовать простой decision framework.
Это не означает, что внешний стек «лучше» встроенного механизма.
Они решают задачи разного масштаба.
Большинство привычных вопросов к этой информации закрываются отчётами:
- сколько продали;
- какие остатки на складах;
- как изменилась задолженность;
- сколько заказов оформил менеджер.
Но есть другой класс вопросов.
Какие товары систематически покупают вместе? Какие действия клиентов образуют повторяющиеся последовательности? Можно ли разделить покупателей на группы без заранее заданных сегментов? Какие характеристики связаны с определённым результатом?
Для таких задач в платформе 1С существует отдельный механизм «Анализ данных и прогнозирование».
Он предназначен не столько для вывода уже известного KPI, сколько для исследования выборки и поиска закономерностей.
Официальная документация 1С также предусматривает использование результатов анализа для последующего построения моделей прогноза.
Но наличие алгоритма внутри платформы ещё не означает, что любой аналитический сценарий разумно решать внутри одной информационной базы.
Разберём сначала сами методы, а затем проведём эту границу.
Отчёт и анализ данных решают разные задачи
Отчёт начинается с известного вопроса.
Например:
Какая выручка была в июле? Система получает данные, группирует их и выводит результат. Механизм анализа данных начинается с другой постановки: Какие закономерности существуют в этой выборке? Поэтому отчёты, СКД и анализ данных не являются взаимозаменяемыми инструментами.
| Бизнес-вопрос | Подход |
|---|---|
| Сколько продали за период | Отчёт / СКД |
| Какие товары находятся на складе | Отчёт / СКД |
| Какие товары часто покупают вместе | Поиск ассоциаций |
| Что клиенты обычно покупают следующим | Поиск последовательностей |
| Какие естественные группы есть среди клиентов | Кластерный анализ |
| Какие признаки связаны с нужным результатом | Дерево решений |
Здесь лучше сначала определить вопрос и только затем выбирать метод.
Как работает механизм «Анализ данных и прогнозирование»
В платформе механизм представлен набором взаимодействующих объектов встроенного языка. Разработчик может использовать их внутри прикладного решения, управлять параметрами анализа программно и получать программный доступ к результату.
Общая последовательность выглядит так:
источник данных → выборка → метод анализа → результат → интерпретация → при необходимости модель прогноза
При этом результат не нужно автоматически считать готовым бизнес-решением.
Если алгоритм обнаружил связь между двумя признаками, ещё требуется ответить:
- почему она возникла;
- насколько устойчива;
- имеет ли бизнес-смысл;
- можно ли применять её к новым данным;
- нет ли в исходной выборке систематической ошибки.
Смысл анализа появляется не в момент запуска алгоритма, а после интерпретации результата.
Какие виды анализа данных есть в 1С
Платформа поддерживает пять основных типов:
- общая статистика;
- поиск ассоциаций;
- поиск последовательностей;
- кластерный анализ;
- дерево решений.
Именно такой набор описывает официальная документация 1С.
Общая статистика
Общая статистика нужна для первоначального исследования выборки.
До поиска сложных закономерностей аналитику полезно понять сами данные:
- какие характеристики представлены;
- как распределяются значения;
- где находятся экстремумы;
- какие признаки дискретные;
- какие поля можно использовать в дальнейшем анализе.
Официальное описание отдельно разделяет непрерывные и дискретные поля.
К непрерывным относятся, например, числа и даты.
Представим клиентскую базу.
До кластеризации можно проверить:
- размер среднего чека;
- число заказов;
- дату последней покупки;
- количество категорий товаров;
- период работы с клиентом.
Так становится понятнее, какие характеристики вообще имеют смысл для последующей сегментации.
Пример предварительного исследования выборки средствами анализа данных 1С.
Поиск ассоциаций
Ассоциативный анализ ищет объекты или значения, которые регулярно встречаются вместе.
Классический пример: покупатель добавил в заказ товар А — какие товары часто встречаются в тех же заказах?
Результатом могут стать устойчивые сочетания и ассоциативные правила.
Официальный механизм также умеет учитывать иерархические данные. Поэтому закономерность можно искать не только между конкретными товарами, но и между товарными группами.
Это расширяет область применения.
Например, можно анализировать:
- товарные сочетания;
- совместно покупаемые услуги;
- комбинации комплектующих;
- повторяющиеся сочетания характеристик клиентов.
Но обнаруженная совместная встречаемость сама по себе ещё не доказывает причинную связь.
Если два товара регулярно оказываются в одном заказе, это не означает, что продажа первого вызывает продажу второго. Возможна третья причина: сезонность, акция, специфика группы покупателей.
Пример ассоциативных правил: система ищет значения, которые регулярно встречаются совместно.
Поиск последовательностей
Здесь важен уже не только набор событий, но и их порядок.
Ассоциация отвечает:
Что встречается вместе?
Последовательность:
Что обычно происходит после чего?
Например, можно исследовать историю заказов клиентов и искать цепочки:
товар А → через определённый период товар Б → затем товар В
Платформа даёт возможность ограничивать временные расстояния между событиями и регулировать параметры результата.
Такая постановка подходит для:
- последовательности покупок;
- поведения клиента;
- повторяющихся операций;
- движения объекта между состояниями;
- анализа этапов процесса.
Порядок здесь принципиален.
Если клиент покупает три товара в любой комбинации, это ассоциация. Если нас интересует устойчивая очередность их приобретения, это уже последовательность.
Пример анализа цепочек событий средствами 1С.
Кластерный анализ
Кластеризация решает другую задачу: пытается разделить объекты на группы по сходству признаков.
Главное отличие от обычной сегментации - группы не задаются заранее.
Допустим, есть несколько тысяч клиентов и набор характеристик:
- частота заказов;
- средний чек;
- продолжительность работы;
- ассортимент;
- интервалы между покупками.
VIP / постоянные / новые / уходящие.
А можно сначала посмотреть, какие группы формируются из самих данных.
Официальный механизм 1С даёт возможность выбирать характеристики, изменять их состав и задавать весовые коэффициенты. Результат может отображаться в форме дендрограммы.
После кластеризации начинается наиболее содержательная часть работы - интерпретация.
Система может сформировать три или пять групп, но назвать их «ключевые клиенты» или «группа риска» уже должен аналитик на основании характеристик каждого кластера.
Пример разделения объектов на группы по сходству признаков.
Дерево решений
Дерево решений используется, когда есть целевой признак и требуется найти набор правил, связанных с ним.
Представим историю сделок.
Для каждой известно:
- результат;
- тип клиента;
- сегмент;
- сумма;
- источник обращения;
- продолжительность сделки.
Можно поставить задачу:
Какие сочетания характеристик связаны с успешным завершением сделки?
Алгоритм формирует иерархическую структуру условий.
Официальное описание 1С приводит аналогичную механику: выбирается целевой атрибут и набор входных признаков, после чего результат строится как дерево классифицирующих правил.
Сильная сторона такого результата - интерпретируемость.
Вместо одного непрозрачного коэффициента пользователь видит последовательность:
если условие А → затем Б → результат относится к определённому классу
Но и здесь нельзя автоматически превращать найденное правило в управленческий вывод.
Сначала нужно проверить качество исходных данных и устойчивость классификации.
Пример классифицирующих правил, сформированных методом дерева решений.
Как выбрать подходящий метод
Полезнее выбирать не алгоритм, а тип вопроса.
| Нужно узнать | Метод |
|---|---|
| Что представляет собой выборка | Общая статистика |
| Что регулярно встречается вместе | Поиск ассоциаций |
| Что следует одно за другим | Поиск последовательностей |
| Какие естественные группы существуют | Кластеризация |
| Какие признаки связаны с целевым результатом | Дерево решений |
Эту последовательность можно использовать и как диагностический фильтр.
Если вопрос звучит: сколько было продаж? вам вообще не нужен этот механизм.
Если: какие клиенты похожи друг на друга по совокупности поведения? это уже задача кластеризации.
Можно ли построить прогноз
Да, но слово «прогнозирование» здесь нужно понимать точно.
Результат выполненного анализа может использоваться для формирования модели, которую затем применяют к новым данным. Официальная документация описывает, например, сценарий, когда найденные ассоциации используются для прогнозирования сопутствующих товаров в новой покупке.
Это не означает, что внутри 1С находится универсальная ML-платформа для любой задачи прогнозирования.
Сначала нужно получить пригодную модель средствами конкретного метода.
Например:
история покупок → поиск ассоциаций → модель → новая покупка → предполагаемые сопутствующие товары
или:
история объектов → дерево решений → модель классификации → новый объект → предполагаемый класс
Что влияет на качество результата
Наличие метода не компенсирует плохую подготовку данных.
Если в источнике:
- дубли;
- некорректные значения;
- недостаточная история;
- систематически незаполненные поля;
- смешаны разные сущности;
- неправильно выбрана выборка, результат анализа может оказаться технически корректным и при этом бесполезным.
Поэтому разумная последовательность выглядит так:
- поставить бизнес-вопрос;
- определить источник;
- проверить качество и состав выборки;
- выбрать метод;
- настроить параметры;
- выполнить расчёт;
- интерпретировать результат;
- проверить его на бизнес-смысле;
- только затем использовать дальше.
Нужен ли для этого разработчик 1С
Сам механизм реализован на уровне объектов встроенного языка. Разработчик может использовать эти объекты в прикладном решении и формировать собственный пользовательский сценарий.
Поэтому ситуация зависит от конфигурации.
Если нужный механизм уже встроен в прикладной интерфейс, пользователь может работать с подготовленным сценарием.
Если требуется:
- подключить новую выборку;
- изменить алгоритм;
- построить собственную форму;
- встроить результат анализа в бизнес-процесс, понадобится разработка.
Это одна из причин, почему вопрос нужно формулировать не так: Есть ли в 1С кластеризация?
а так: Насколько трудоёмко реализовать требуемый аналитический сценарий в нашем конкретном контуре?
Где заканчиваются возможности одной базы 1С
До этого момента мы говорили об алгоритмах. Но в корпоративной аналитике проблема нередко возникает уровнем выше — в архитектуре данных.
Представим, что продажи находятся в ERP, клиентская активность — в CRM, маркетинговые расходы — во внешнем сервисе, а часть финансовых данных — ещё в одной базе 1С.
Тогда главный вопрос уже не: Какой вид анализа выбрать? А: Как получить согласованный набор данных для анализа?
Именно здесь проходит граница между локальной аналитической задачей внутри одной информационной базы и корпоративным аналитическим контуром.
Встроенный механизм хорошо подходит, когда:
- необходимые данные доступны в одной базе;
- задача укладывается в поддерживаемые методы;
- нет сложного объединения нескольких источников;
- результат удобно использовать внутри прикладного решения.
Отдельный контур данных становится оправданным, когда:
- используется несколько баз 1С;
- нужно соединить 1С с CRM, WMS, Excel, API или внешними БД;
- требуется единая историческая модель;
- нужны корпоративные витрины;
- расчёты должны быть одинаковыми для нескольких отчётов;
- необходимо отделить аналитическую нагрузку от рабочей 1С;
- данные используются несколькими BI-системами или командами.
Это уже другая архитектурная задача.
Как выглядит внешний аналитический контур
Для такого сценария разделяются получение, преобразование, хранение и визуализация данных.
Например:
Если баз 1С несколько:
Экстрактор данных 1С
Экстрактор используется для получения данных из одной или нескольких информационных баз 1С и передачи их во внешний слой.
Это отделяет задачу извлечения данных от аналитической логики.
Denvic Visual Transformer
DVT подключается, когда данные нужно:
- объединить;
- очистить;
- сопоставить;
- преобразовать;
- агрегировать;
- подготовить для аналитической витрины.
То есть решение переносится из логики: «построить ещё один сложный отчёт внутри каждой базы» в логику: «собрать единый слой данных, на котором работают разные аналитические сценарии».
Как понять, нужен ли внешний контур
Можно использовать простой decision framework.
| Ситуация | Разумный подход |
|---|---|
| Один известный показатель внутри одной 1С | Отчёт / СКД |
| Поиск закономерности в данных одной базы | Встроенный анализ |
| Несколько баз 1С | Экстрактор + внешний слой |
| 1С + CRM / API / Excel / другие БД | Экстрактор + DVT |
| Единая история и корпоративные витрины | Экстрактор + DVT + DWH |
| Управленческие дашборды на нескольких источниках | Внешний аналитический контур |
Это не означает, что внешний стек «лучше» встроенного механизма.
Они решают задачи разного масштаба.