Назад
Low-code ETL подходит там, где значительная часть преобразований повторяется, требования регулярно меняются, а аналитикам нужен доступ к подготовке данных без очереди на каждую небольшую доработку. Код остаётся рациональным выбором для нестандартной логики, собственных библиотек, сложного CI/CD и участков, где инженеру нужен полный контроль над исполнением.
Поэтому сравнивать подходы только по скорости первой разработки бесполезно. Гораздо показательнее другой вопрос: кто будет менять этот конвейер через полгода, как команда найдёт ошибку и сколько будет стоить очередная версия?
Представим управленческую витрину. Продажи находятся в 1С, лиды приходят из CRM, план финансовый отдел ведёт в Excel. Данные нужно привести к общей структуре, связать по подразделениям и продуктам, рассчитать показатели и каждое утро обновлять витрину в DWH.
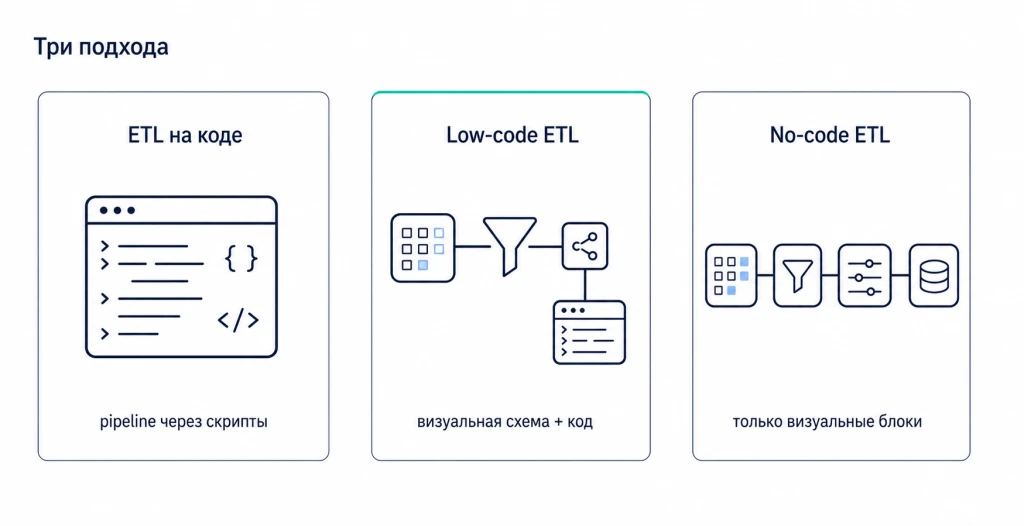
У команды есть три базовых варианта.
На демонстрации все три варианта способны показать одинаковый результат: источник подключён, таблица обработана, данные записаны.
Разница проявится позже.
В CRM поменяется API. Финансовый отдел попросит добавить новое измерение. В Excel появится ещё один вариант названия подразделения. Объём таблицы вырастет в несколько раз. Расчёт, который создавали для одного отчёта, понадобится другому проекту.
Вот тогда становится видна настоящая стоимость архитектурного решения.
Собственный код даёт инженеру максимальную свободу. Можно написать нестандартный API-клиент, подключить специализированную библиотеку, реализовать собственный алгоритм сопоставления или оптимизировать SQL под конкретную СУБД.
Если data-команда уже работает через Git, code review, тесты и CI/CD, ETL естественно встраивается в тот же инженерный процесс. Для платформенного слоя с большим количеством зависимостей это может оказаться самым понятным вариантом.
Цена появляется на изменениях.
Бизнес просит добавить поле «Регион продаж» и исключить тестовых клиентов. Само преобразование может занимать две строки SQL, но до production эти две строки проходят поиск нужного пайплайна, изменение кода, проверку зависимостей, тестирование, review, развёртывание и контроль результата.
Для критичного DWH такая процедура оправдана. Если подобных запросов приходят десятки, дата-инженер начинает тратить значительную часть времени на мелкие изменения существующей логики.
Проверить ситуацию можно простым способом: возьмите последние 20 задач data-команды и разделите их на архитектурные изменения, нестандартную разработку и типовые корректировки фильтров, полей, Join и расчётов. Если третья группа занимает заметную долю очереди, визуальный слой заслуживает отдельной оценки.
Главное изменение связано с формой описания процесса.
Вместо большого фрагмента программы команда видит последовательность операций:
источник → фильтрация → Join → расчёт → агрегация → проверка → запись
Аналитик способен менять типовые участки процесса, если понимает структуру данных и бизнес-логику. Data-инженер сосредотачивается на архитектуре, сложном SQL и Python, производительности, нестандартных источниках, ресурсах, безопасности и эксплуатации.
Такое разделение работает при одном условии: визуальный граф должен оставаться читаемым.
Если процесс вырос до сотни плохо названных нод, ветки пересекаются, а SQL и Python спрятаны в случайных блоках, преимущество визуального представления быстро исчезает. Перед командой снова сложная система, просто описанная другим способом.
Для low-code поэтому нужны те же инженерные привычки: понятные имена, небольшие самостоятельные процессы, повторно используемые компоненты, контроль схем, обработка ошибок и прогнозируемое место для нестандартного кода.
Допустим, аналитик собирает витрину:
Продажи + Менеджеры + Регионы → Group By → PostgreSQL
В кодовом проекте логика может оказаться внутри SQL на несколько сотен строк. Новый сотрудник сначала восстанавливает структуру запроса и зависимости между CTE, Join и расчётами.
В визуальном конвейере последовательность видна до чтения деталей: где приходит источник, на каком этапе фильтруются записи, где подключается справочник и куда записывается итог.
Это работает, когда большая часть задачи состоит из стандартных операций над данными.
DVT, например, содержит готовые ноды для Filter, GroupBy, Join, Union, Pivot, Unpivot, Regex Replace, изменения типов, переименования колонок и других преобразований. Для пользовательской логики доступна отдельная Python-нода.
Проверка при выборе платформы проста: дайте другому специалисту открыть готовый pipeline без объяснений автора. Если через несколько минут он способен показать источник, основные преобразования и приёмник, визуальная модель выполняет свою задачу.
Где no-code начинает ограничивать архитектуру
No-code удобен, пока требование укладывается в библиотеку готовых действий.
Пример: прочитать таблицу, отфильтровать строки, присоединить справочник и записать результат. Для такой цепочки программирование действительно может оказаться лишним.
Теперь представим другое поле. В нём лежит JSON с массивом событий. Нужно выбрать последнее событие каждого типа, применить несколько специальных правил и сопоставить результат с историей статусов.
Если готовой операции нет, команда либо строит сложный обходной граф, либо выносит обработку во внешний сервис.
Low-code оставляет третий путь: сохранить основной pipeline визуальным и написать код только для участка, где готовые операции уже хуже собственного алгоритма.
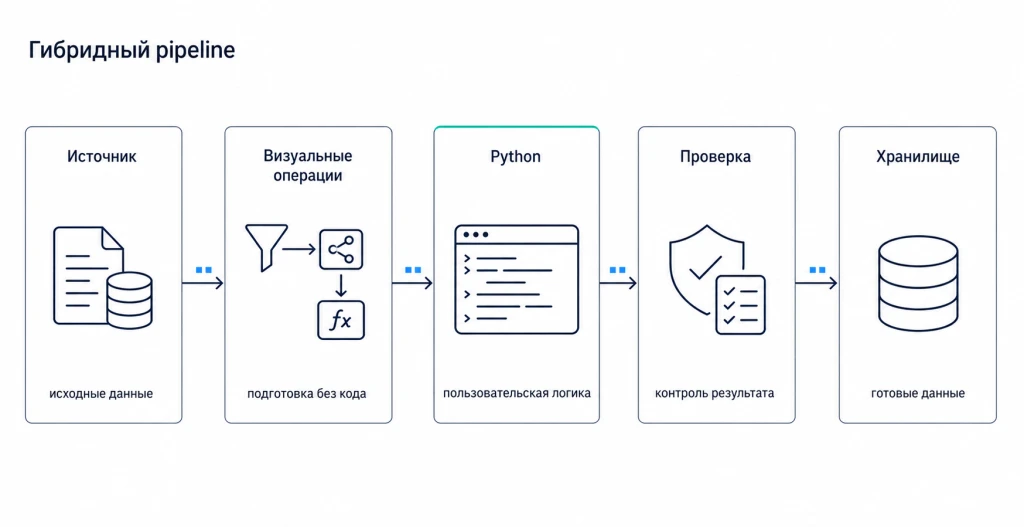
В документации DVT показан такой сценарий: поток делится на части, одна ветка обрабатывается через Execute Python Code on DataFrame, затем результаты снова объединяются.
Именно по этому признаку удобно проверять границу no-code-платформы: что произойдёт с проектом, когда появится первая операция, которой нет в библиотеке?
Visual-first подход подходит далеко не каждому data-контуру.
Код имеет преимущество, если команда строит платформенный слой с сотнями зависимых процессов, собственными библиотеками, строгим автоматизированным тестированием, Infrastructure as Code, сложным CI/CD и требованиями к переносимости между средами.
То же относится к отдельным тяжёлым преобразованиям. Если оптимизированный SQL внутри ClickHouse или PostgreSQL выполняет задачу компактнее и прозрачнее, раскладывать его на пятнадцать визуальных операций нет причины.
Проверять здесь стоит не количество строк кода, а стоимость эксплуатации: можно ли тестировать процесс, повторно использовать компоненты, отслеживать версии, диагностировать сбой и передать проект другому инженеру.
Выбор ETL не обязан распространяться на всю data-платформу.
В одном контуре вполне могут сосуществовать кодовые процессы для платформенного ядра, low-code для аналитических витрин и повторяемых интеграций, а простые no-code-сценарии использоваться в локальных задачах.
Такой вариант особенно логичен в компании, где data engineering и BI развиваются параллельно. Платформенная команда сохраняет контроль над ядром, аналитики получают более короткий цикл изменений в своих витринах.
Критерий здесь один: граница ответственности должна быть понятна заранее. Команда должна знать, какая логика относится к платформе, какая к аналитической модели и где допустимо локальное пользовательское преобразование.
Эта таблица полезнее абстрактного сравнения «быстро – медленно» или «дорого – дёшево». Она заставляет проверять эксплуатацию, которую легко пропустить на демонстрации.
Термин low-code сам по себе ничего не говорит о производительности.
На скорость влияют алгоритм, СУБД, объём передаваемых данных, место исполнения трансформации, размер партиций, параллелизм, память и архитектура конкретного pipeline.
В DVT проект строится как ацикличный граф. Документация связывает его исполнение с подходом Dask: граф формируется для ленивого выполнения, а архитектура предусматривает распределённые вычисления. Для чтения произвольных SQL-запросов Read Query DB V3 поддерживает сегментацию, при которой большой набор читается параллельно по частям.
Эти механизмы сами по себе не доказывают превосходство над оптимизированным SQL. Производительность нужно измерять на реальном объёме конкретной задачи.
Для пилота поэтому стоит взять не демонстрационную таблицу на десять тысяч строк, а один из рабочих наборов компании и проверить время чтения, преобразования, записи и потребление ресурсов.
ETL чаще открывают в момент сбоя, чем в момент красивой демонстрации.
Утром витрина не обновилась. Команде нужны ответы: какой проект завершился ошибкой, сколько он выполнялся, на каком этапе произошёл сбой и какие данные дошли до проблемного шага.
В DVT для проектов доступны история запусков и статусы выполнения, а документация отдельно описывает просмотр датафреймов и работу с очередью задач. Расписание можно задавать внутри DVT, включая cron-выражения.
При выборе любого ETL-инструмента этот сценарий стоит разыграть заранее: намеренно сломать одну операцию и посмотреть, сколько времени потребуется другому человеку, чтобы найти причину.
Представим, что поле amount вчера приходило как Decimal, а после обновления системы начало приходить как String.
Если pipeline принимает такое изменение без контроля, ошибка способна пройти дальше и проявиться уже в расчёте витрины.
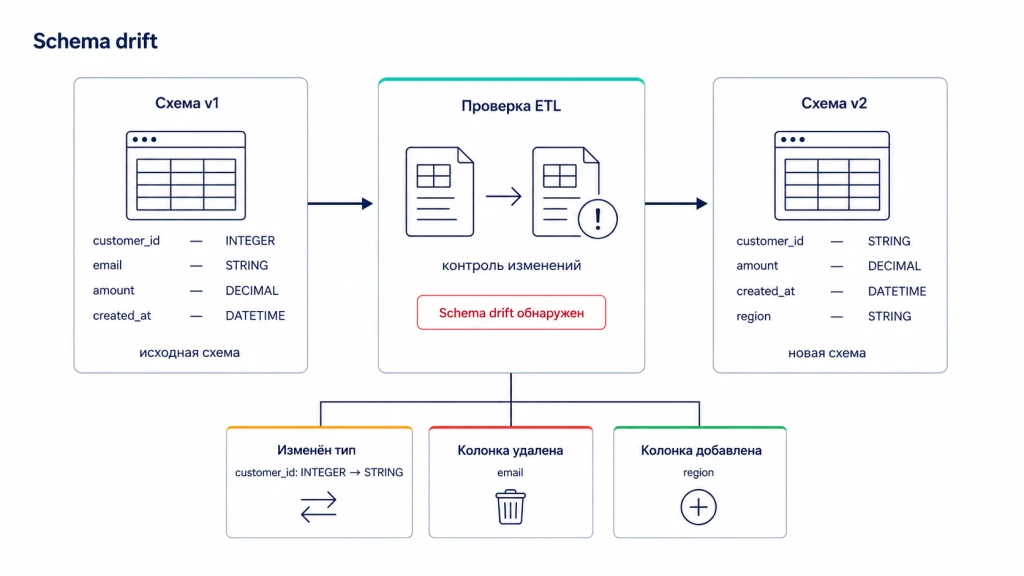
В DVT 1.20.0, выпущенном 10 августа 2026 года, появились Convert To Schema и Schema Policy. Первая нода формирует эталонную структуру, вторая используется для приведения и контроля данных относительно этой схемы перед записью. В структуре учитываются имена и типы колонок, обязательность, значения по умолчанию, ключи и другие атрибуты.
Проверка для пилота: измените тип одного поля, удалите колонку и добавьте новую. Посмотрите, где система обнаружит изменение и что получит downstream-процесс.
Визуальный редактор не принимает архитектурные решения.
Команде всё равно придётся определить гранулярность данных, ключи, историчность, правила master data, место тяжёлых Join, стратегию schema drift, разграничение доступа и способ тестирования бизнес-метрик.
Поэтому обещание «ETL теперь может делать любой пользователь» плохо описывает корпоративную работу с данными.
Аналитик действительно может самостоятельно собирать часть типовых процессов. Официальная страница DVT разделяет сценарии похожим образом: готовые визуальные операции адресованы аналитической работе, SQL, Python, HTTP и расширения остаются инструментами для более сложной инженерной логики.
Это работает, когда архитектор заранее определил границы самостоятельности.
Для данных 1С возникает отдельная задача: сначала информацию нужно получить из рабочей базы и передать дальше.
В экосистеме Denvic компоненты разделены по роли. Экстрактор 1С занимается выгрузкой данных из 1С, DVT – их дальнейшей трансформацией, а Инжектор 1С – записью подготовленной информации обратно в объекты 1С. Документация указывает, что эти сервисы могут использоваться как совместно, так и отдельно.
Для аналитического сценария архитектура может выглядеть так:
1С:ERP → Экстрактор 1С → DVT → DWH → BI
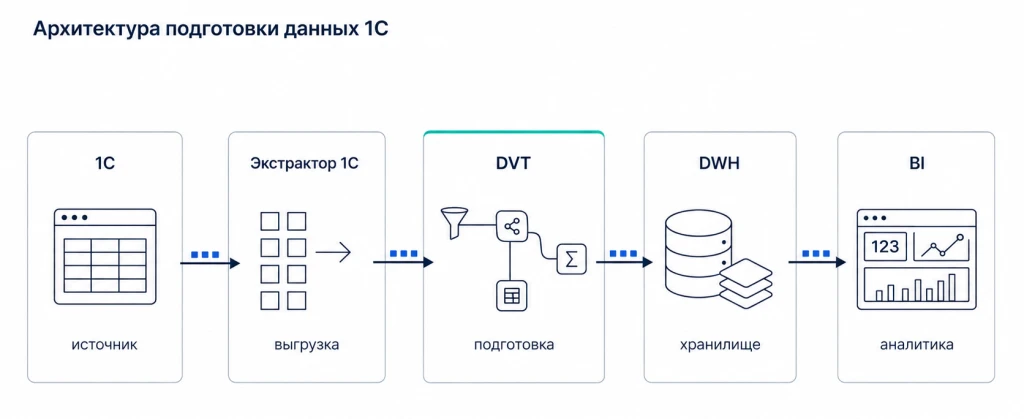
Если к данным 1С нужно добавить CRM и Excel, DVT получает более понятную роль: объединить источники, очистить значения, применить расчёты, привести структуру и сформировать аналитическую витрину.
Если задача ограничена простой выгрузкой из одной 1С в целевую систему, отдельный слой трансформации может только усложнить архитектуру. Это хороший пример продуктовой границы, которую стоит определить до выбора стека.
Для простого стабильного потока из готовых операций no-code может закрыть задачу с минимальным количеством компонентов.
Если большая часть обработки типовая, но периодически требуются SQL, Python, нестандартные API или сложные правила, low-code даёт больше пространства для развития.
Кодовый подход рационален там, где сама трансформация представляет собой программный продукт: со специализированными библиотеками, строгими тестами, CI/CD и большим количеством уникальной логики.
В большой организации наиболее реалистичен смешанный контур. Разные классы задач получают разные инструменты, а архитектурная политика определяет, где проходит граница.
Возьмите один рабочий pipeline, в котором есть несколько типов операций. Например:
1С → продажи → CRM → план Excel → витрина
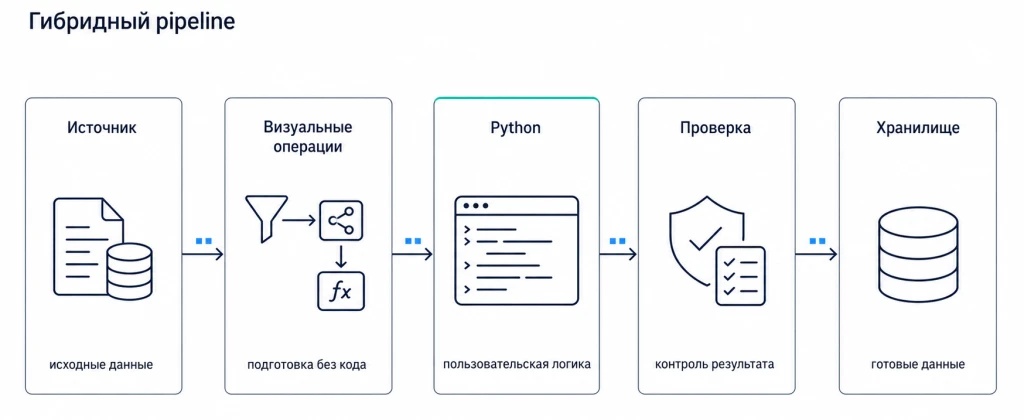
Затем измерьте первую реализацию, внесите изменение бизнес-правила, намеренно сломайте одно поле, измените схему источника и передайте проект сотруднику, который его раньше не видел.
После такого теста появятся ответы на вопросы, которые презентация продукта обычно скрывает: кто действительно может сопровождать pipeline, где потребовался код, насколько быстро диагностируется ошибка и что происходит при росте объёма.
Именно этот пилот превращает выбор ETL из спора о технологиях в инженерное решение.
У Code-Based, Low-Code и No-Code ETL разная стоимость владения.
Код даёт максимальную свободу, но требует инженерного процесса вокруг каждого изменения. No-code сокращает порог входа, пока задача остаётся внутри готовой библиотеки операций. Low-code занимает промежуточную область: типовая логика остаётся визуальной, сложные участки можно реализовать через SQL или Python.
Поэтому перед выбором стоит проверить три вещи: кто будет сопровождать pipeline через полгода, какая доля логики действительно требует программирования и сколько времени команда потратит на диагностику сбоя.
Если ответ получен на реальном процессе и рабочем объёме данных, выбор перестаёт зависеть от моды на конкретный подход.
Поэтому сравнивать подходы только по скорости первой разработки бесполезно. Гораздо показательнее другой вопрос: кто будет менять этот конвейер через полгода, как команда найдёт ошибку и сколько будет стоить очередная версия?
Low-code, no-code и классический ETL решают разные задачи
Представим управленческую витрину. Продажи находятся в 1С, лиды приходят из CRM, план финансовый отдел ведёт в Excel. Данные нужно привести к общей структуре, связать по подразделениям и продуктам, рассчитать показатели и каждое утро обновлять витрину в DWH.
У команды есть три базовых варианта.
| Подход | Как строится процесс | Где появляется ограничение |
|---|---|---|
| Code-Based ETL | SQL, Python и другие инструменты инженерного стека | Каждое изменение проходит через разработку и сопровождение кода |
| No-Code ETL | Готовые визуальные операции без программирования | Нестандартная логика ограничена возможностями платформы |
| Low-Code ETL | Основной поток собирается визуально, сложные участки можно вынести в SQL или Python | Требует архитектурной дисциплины и понимания границ визуальной модели |
На демонстрации все три варианта способны показать одинаковый результат: источник подключён, таблица обработана, данные записаны.
Разница проявится позже.
В CRM поменяется API. Финансовый отдел попросит добавить новое измерение. В Excel появится ещё один вариант названия подразделения. Объём таблицы вырастет в несколько раз. Расчёт, который создавали для одного отчёта, понадобится другому проекту.
Вот тогда становится видна настоящая стоимость архитектурного решения.
Когда ETL на коде оправдывает стоимость разработки
Собственный код даёт инженеру максимальную свободу. Можно написать нестандартный API-клиент, подключить специализированную библиотеку, реализовать собственный алгоритм сопоставления или оптимизировать SQL под конкретную СУБД.
Если data-команда уже работает через Git, code review, тесты и CI/CD, ETL естественно встраивается в тот же инженерный процесс. Для платформенного слоя с большим количеством зависимостей это может оказаться самым понятным вариантом.
Цена появляется на изменениях.
Бизнес просит добавить поле «Регион продаж» и исключить тестовых клиентов. Само преобразование может занимать две строки SQL, но до production эти две строки проходят поиск нужного пайплайна, изменение кода, проверку зависимостей, тестирование, review, развёртывание и контроль результата.
Для критичного DWH такая процедура оправдана. Если подобных запросов приходят десятки, дата-инженер начинает тратить значительную часть времени на мелкие изменения существующей логики.
Проверить ситуацию можно простым способом: возьмите последние 20 задач data-команды и разделите их на архитектурные изменения, нестандартную разработку и типовые корректировки фильтров, полей, Join и расчётов. Если третья группа занимает заметную долю очереди, визуальный слой заслуживает отдельной оценки.
Что low-code меняет в работе с ETL
Главное изменение связано с формой описания процесса.
Вместо большого фрагмента программы команда видит последовательность операций:
источник → фильтрация → Join → расчёт → агрегация → проверка → запись
Аналитик способен менять типовые участки процесса, если понимает структуру данных и бизнес-логику. Data-инженер сосредотачивается на архитектуре, сложном SQL и Python, производительности, нестандартных источниках, ресурсах, безопасности и эксплуатации.
Такое разделение работает при одном условии: визуальный граф должен оставаться читаемым.
Если процесс вырос до сотни плохо названных нод, ветки пересекаются, а SQL и Python спрятаны в случайных блоках, преимущество визуального представления быстро исчезает. Перед командой снова сложная система, просто описанная другим способом.
Для low-code поэтому нужны те же инженерные привычки: понятные имена, небольшие самостоятельные процессы, повторно используемые компоненты, контроль схем, обработка ошибок и прогнозируемое место для нестандартного кода.
Где визуальный ETL даёт понятное преимущество
Допустим, аналитик собирает витрину:
Продажи + Менеджеры + Регионы → Group By → PostgreSQL
В кодовом проекте логика может оказаться внутри SQL на несколько сотен строк. Новый сотрудник сначала восстанавливает структуру запроса и зависимости между CTE, Join и расчётами.
В визуальном конвейере последовательность видна до чтения деталей: где приходит источник, на каком этапе фильтруются записи, где подключается справочник и куда записывается итог.
Это работает, когда большая часть задачи состоит из стандартных операций над данными.
DVT, например, содержит готовые ноды для Filter, GroupBy, Join, Union, Pivot, Unpivot, Regex Replace, изменения типов, переименования колонок и других преобразований. Для пользовательской логики доступна отдельная Python-нода.
Проверка при выборе платформы проста: дайте другому специалисту открыть готовый pipeline без объяснений автора. Если через несколько минут он способен показать источник, основные преобразования и приёмник, визуальная модель выполняет свою задачу.
Где no-code начинает ограничивать архитектуру
No-code удобен, пока требование укладывается в библиотеку готовых действий.
Пример: прочитать таблицу, отфильтровать строки, присоединить справочник и записать результат. Для такой цепочки программирование действительно может оказаться лишним.
Теперь представим другое поле. В нём лежит JSON с массивом событий. Нужно выбрать последнее событие каждого типа, применить несколько специальных правил и сопоставить результат с историей статусов.
Если готовой операции нет, команда либо строит сложный обходной граф, либо выносит обработку во внешний сервис.
Low-code оставляет третий путь: сохранить основной pipeline визуальным и написать код только для участка, где готовые операции уже хуже собственного алгоритма.
В документации DVT показан такой сценарий: поток делится на части, одна ветка обрабатывается через Execute Python Code on DataFrame, затем результаты снова объединяются.
Именно по этому признаку удобно проверять границу no-code-платформы: что произойдёт с проектом, когда появится первая операция, которой нет в библиотеке?
Когда сразу выбирать код
Visual-first подход подходит далеко не каждому data-контуру.
Код имеет преимущество, если команда строит платформенный слой с сотнями зависимых процессов, собственными библиотеками, строгим автоматизированным тестированием, Infrastructure as Code, сложным CI/CD и требованиями к переносимости между средами.
То же относится к отдельным тяжёлым преобразованиям. Если оптимизированный SQL внутри ClickHouse или PostgreSQL выполняет задачу компактнее и прозрачнее, раскладывать его на пятнадцать визуальных операций нет причины.
Проверять здесь стоит не количество строк кода, а стоимость эксплуатации: можно ли тестировать процесс, повторно использовать компоненты, отслеживать версии, диагностировать сбой и передать проект другому инженеру.
Почему в одной компании могут понадобиться оба подхода
Выбор ETL не обязан распространяться на всю data-платформу.
В одном контуре вполне могут сосуществовать кодовые процессы для платформенного ядра, low-code для аналитических витрин и повторяемых интеграций, а простые no-code-сценарии использоваться в локальных задачах.
Такой вариант особенно логичен в компании, где data engineering и BI развиваются параллельно. Платформенная команда сохраняет контроль над ядром, аналитики получают более короткий цикл изменений в своих витринах.
Критерий здесь один: граница ответственности должна быть понятна заранее. Команда должна знать, какая логика относится к платформе, какая к аналитической модели и где допустимо локальное пользовательское преобразование.
Семь вопросов, которые стоит задать до выбора ETL-платформы
| Вопрос | Что проверить |
|---|---|
| Кто будет менять pipeline? | Только data-инженеры или также аналитики |
| Насколько нестандартна логика? | Хватает ли Filter, Join, GroupBy и типовых операций |
| Как часто меняются требования? | Сколько изменений проходит через очередь разработки |
| Что происходит при ошибке? | Видны ли статус, проблемная нода, лог и промежуточные данные |
| Что произойдёт при росте объёма? | Где выполняются вычисления, есть ли сегментация и параллельная обработка |
| Как контролируется схема? | Что произойдёт при удалении поля или смене его типа |
| Насколько высок vendor lock-in? | Можно ли вынести часть логики в SQL/Python и восстановить её вне платформы |
Эта таблица полезнее абстрактного сравнения «быстро – медленно» или «дорого – дёшево». Она заставляет проверять эксплуатацию, которую легко пропустить на демонстрации.
Что происходит с ETL при росте объёма данных
Термин low-code сам по себе ничего не говорит о производительности.
На скорость влияют алгоритм, СУБД, объём передаваемых данных, место исполнения трансформации, размер партиций, параллелизм, память и архитектура конкретного pipeline.
В DVT проект строится как ацикличный граф. Документация связывает его исполнение с подходом Dask: граф формируется для ленивого выполнения, а архитектура предусматривает распределённые вычисления. Для чтения произвольных SQL-запросов Read Query DB V3 поддерживает сегментацию, при которой большой набор читается параллельно по частям.
Эти механизмы сами по себе не доказывают превосходство над оптимизированным SQL. Производительность нужно измерять на реальном объёме конкретной задачи.
Для пилота поэтому стоит взять не демонстрационную таблицу на десять тысяч строк, а один из рабочих наборов компании и проверить время чтения, преобразования, записи и потребление ресурсов.
Как проверить диагностику до покупки visual ETL
ETL чаще открывают в момент сбоя, чем в момент красивой демонстрации.
Утром витрина не обновилась. Команде нужны ответы: какой проект завершился ошибкой, сколько он выполнялся, на каком этапе произошёл сбой и какие данные дошли до проблемного шага.
В DVT для проектов доступны история запусков и статусы выполнения, а документация отдельно описывает просмотр датафреймов и работу с очередью задач. Расписание можно задавать внутри DVT, включая cron-выражения.
При выборе любого ETL-инструмента этот сценарий стоит разыграть заранее: намеренно сломать одну операцию и посмотреть, сколько времени потребуется другому человеку, чтобы найти причину.
Почему изменение схемы источника нужно проверять отдельно
Представим, что поле amount вчера приходило как Decimal, а после обновления системы начало приходить как String.
Если pipeline принимает такое изменение без контроля, ошибка способна пройти дальше и проявиться уже в расчёте витрины.
В DVT 1.20.0, выпущенном 10 августа 2026 года, появились Convert To Schema и Schema Policy. Первая нода формирует эталонную структуру, вторая используется для приведения и контроля данных относительно этой схемы перед записью. В структуре учитываются имена и типы колонок, обязательность, значения по умолчанию, ключи и другие атрибуты.
Проверка для пилота: измените тип одного поля, удалите колонку и добавьте новую. Посмотрите, где система обнаружит изменение и что получит downstream-процесс.
Что low-code оставляет дата-инженеру
Визуальный редактор не принимает архитектурные решения.
Команде всё равно придётся определить гранулярность данных, ключи, историчность, правила master data, место тяжёлых Join, стратегию schema drift, разграничение доступа и способ тестирования бизнес-метрик.
Поэтому обещание «ETL теперь может делать любой пользователь» плохо описывает корпоративную работу с данными.
Аналитик действительно может самостоятельно собирать часть типовых процессов. Официальная страница DVT разделяет сценарии похожим образом: готовые визуальные операции адресованы аналитической работе, SQL, Python, HTTP и расширения остаются инструментами для более сложной инженерной логики.
Это работает, когда архитектор заранее определил границы самостоятельности.
Как low-code ETL встроить в контур данных 1С
Для данных 1С возникает отдельная задача: сначала информацию нужно получить из рабочей базы и передать дальше.
В экосистеме Denvic компоненты разделены по роли. Экстрактор 1С занимается выгрузкой данных из 1С, DVT – их дальнейшей трансформацией, а Инжектор 1С – записью подготовленной информации обратно в объекты 1С. Документация указывает, что эти сервисы могут использоваться как совместно, так и отдельно.
Для аналитического сценария архитектура может выглядеть так:
1С:ERP → Экстрактор 1С → DVT → DWH → BI
Если к данным 1С нужно добавить CRM и Excel, DVT получает более понятную роль: объединить источники, очистить значения, применить расчёты, привести структуру и сформировать аналитическую витрину.
Если задача ограничена простой выгрузкой из одной 1С в целевую систему, отдельный слой трансформации может только усложнить архитектуру. Это хороший пример продуктовой границы, которую стоит определить до выбора стека.
Как выбрать между low-code, no-code и кодом
Для простого стабильного потока из готовых операций no-code может закрыть задачу с минимальным количеством компонентов.
Если большая часть обработки типовая, но периодически требуются SQL, Python, нестандартные API или сложные правила, low-code даёт больше пространства для развития.
Кодовый подход рационален там, где сама трансформация представляет собой программный продукт: со специализированными библиотеками, строгими тестами, CI/CD и большим количеством уникальной логики.
В большой организации наиболее реалистичен смешанный контур. Разные классы задач получают разные инструменты, а архитектурная политика определяет, где проходит граница.
Как провести пилот ETL без маркетингового сравнения
Возьмите один рабочий pipeline, в котором есть несколько типов операций. Например:
1С → продажи → CRM → план Excel → витрина
Затем измерьте первую реализацию, внесите изменение бизнес-правила, намеренно сломайте одно поле, измените схему источника и передайте проект сотруднику, который его раньше не видел.
После такого теста появятся ответы на вопросы, которые презентация продукта обычно скрывает: кто действительно может сопровождать pipeline, где потребовался код, насколько быстро диагностируется ошибка и что происходит при росте объёма.
Именно этот пилот превращает выбор ETL из спора о технологиях в инженерное решение.
Вывод
У Code-Based, Low-Code и No-Code ETL разная стоимость владения.
Код даёт максимальную свободу, но требует инженерного процесса вокруг каждого изменения. No-code сокращает порог входа, пока задача остаётся внутри готовой библиотеки операций. Low-code занимает промежуточную область: типовая логика остаётся визуальной, сложные участки можно реализовать через SQL или Python.
Поэтому перед выбором стоит проверить три вещи: кто будет сопровождать pipeline через полгода, какая доля логики действительно требует программирования и сколько времени команда потратит на диагностику сбоя.
Если ответ получен на реальном процессе и рабочем объёме данных, выбор перестаёт зависеть от моды на конкретный подход.